
【簡易版】AI音声認識による日本語発音テストツールを作ってみた
みなさん、こんにちは!バイタリフィアジアのNiheiです。普段は、生成AIを活用したプロダクト開発をアドバイスしたり、プロジェクトマネージャー (PM / PMO) として様々な開発PJをご支援しております。
今回は、外国人の方の日本語力をちょっと簡単に使ってみるだけで判定できるツールを作ってみました。といっても、ネイティブな日本語力を目指すための第一歩として、発音や抑揚がどれだけ近いかな?というのをチェックする仕組みを入れています。
概要
このツールでは、ユーザーが録音した音声と、あらかじめ用意してある「ネイティブの音声(参照音声)」を比較します。主にやっているのは以下の2つです:
- 録音した音声と参照音声の基本周波数(F0)の違いをチェックして、“話し方の抑揚” が似ているかどうかを数値化。
- 録音した音声から音声認識を使って文字を取り出し、正解のテキストと比べてどれだけ一致しているかを計算。
こうすることで、「イントネーションはネイティブっぽいけど、単語はちょっと違うかも」「文字はほぼ完璧だけど、抑揚がまだぎこちないかも」みたいな分析が一目でわかります。
本編
実際の動きとしては、このような流れになっています。
- 録音: 読み上げるテキストが表示されているため、それを読み上げます。ボタンを押すと、マイクから音声を録音します。録音が終わると、ツールの中に音声データが保存されます。

- 読み上げた後に、「類似度分析」ボタンを押します。

- 音声の分析: その音声から基本周波数(F0)を抽出して、どんな抑揚かを数値データにします。
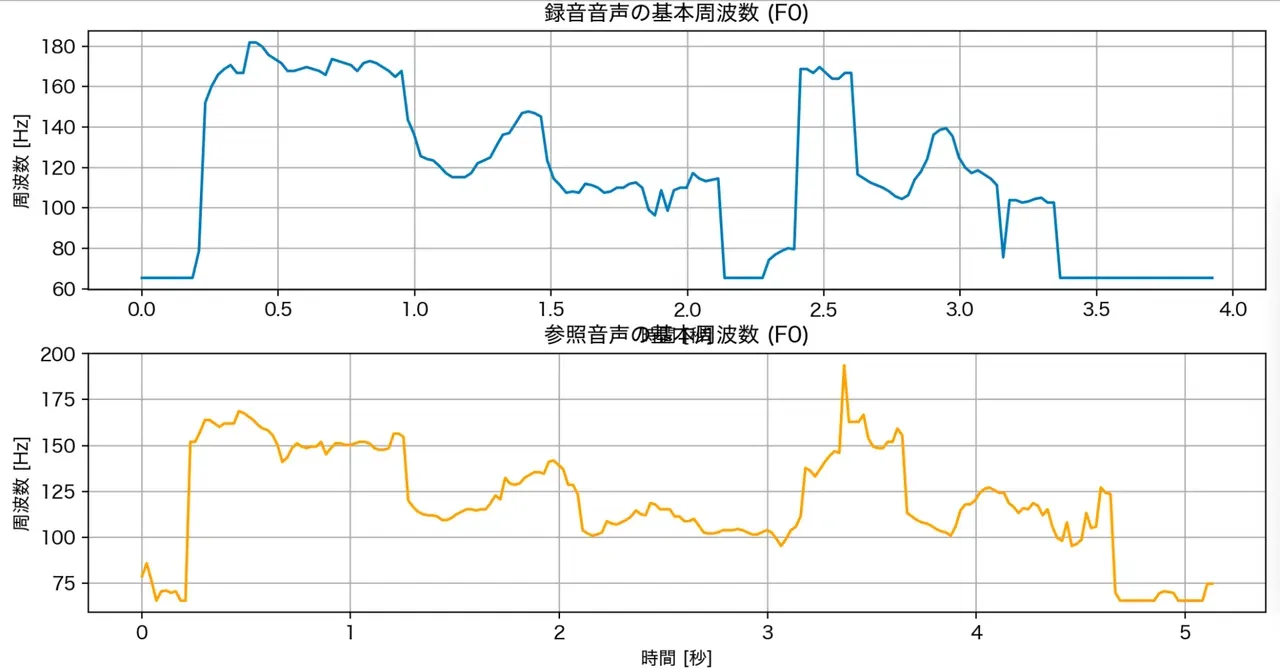
- 参照音声との比較: ネイティブの発音と録音した発音を比べると「どれだけ似ているのか」を計算できます。動的時間伸縮(DTW)という手法で、長さが違う音声でもうまく比較できます。

上記のようなグラフが表示されました。予め録音しておいた参照音声と、いま録音をした音声との一致率の比較を行った結果、0.83 ( 83% ) と表示されました。
- 文字起こし&照合: Whisperなどの音声認識を使って、録音した音声を文字にします。そして、正解テキストとどれだけ一字一句そろっているかをチェックすることで、“正確さ” を数値化します。

上記のように、参照音声を文字起こししてひらがなにした文章と、いま録音した音声を文字起こししてひらがなにした文章の文字の一致率を比較した結果、テキスト一致率は、0.97 ( 97% ) でした。
- 結果の表示: 最後に、似ている度合いや文字の一致率をグラフや数値で見られるようになっています。これを見れば、録音した日本語の発音や一位率がどんな状態かざっくり把握できます。

まとめ
このツールの仕組みを応用すると、日本語を話す外国人人材の日本語力のレベル感がわかりやすくなるほか、「もうちょっとイントネーションをこう直せばいいのかも」「ここは正しい単語だけど発音が惜しい!」なんて気づきが得られます。学習者の方だけでなく、外国人スタッフの日本語力をざっくりチェックしたい企業さんにも役立つかもしれません。
もし「うちでも使ってみたい!」「どうやってカスタマイズできるの?」など、気になることがありましたら、お気軽にお問い合わせください。みなさんのお仕事や学習に、少しでもお役に立てれば嬉しいです。
関連記事
世界初のAIマネジメント規格「ISO/IEC 42001」企業が求めるAIガバナンスと認証の仕組み
ISO/IEC 42001は、AIを安全かつ責任ある形で開発・導入・運用するためのAIマネジメントシステム(AIMS)の国際規格です。本記事では、PDCA、AIリスク・インパクト評価、附属書Aの38の管理策、第三者AIの管理、認証、EU AI Actとの関係まで体系的に解説します。
AI開発の「共通言語」ISO/IEC 22989とは?エンジニアとPMが知っておくべきAI用語・ライフサイクルの世界標準
ISO/IEC 22989は、AI分野の概念と用語を定義する国際標準です。本記事では、AI・機械学習・ディープラーニングの関係、AIシステムのライフサイクル、Trustworthiness、Provider・Customer・User・Subjectの役割まで、エンジニアやPMが実務で使える形で整理します。
LLMワークフロー設計の考え方 | AIに考えさせなくていい業務のほうが実は多い
AIを使った多段処理は、すべてをエージェント化する必要はありません。本記事では、処理順序を固定するLLMワークフローとAIエージェントの違いを整理し、工程分割、再試行、待機、冪等性、コスト・所要時間の見積もり、両者を組み合わせる実務的な設計方法を解説します。
