3DGSを理解する 第2回:3DGSはフォトグラメトリと何が違うのか?
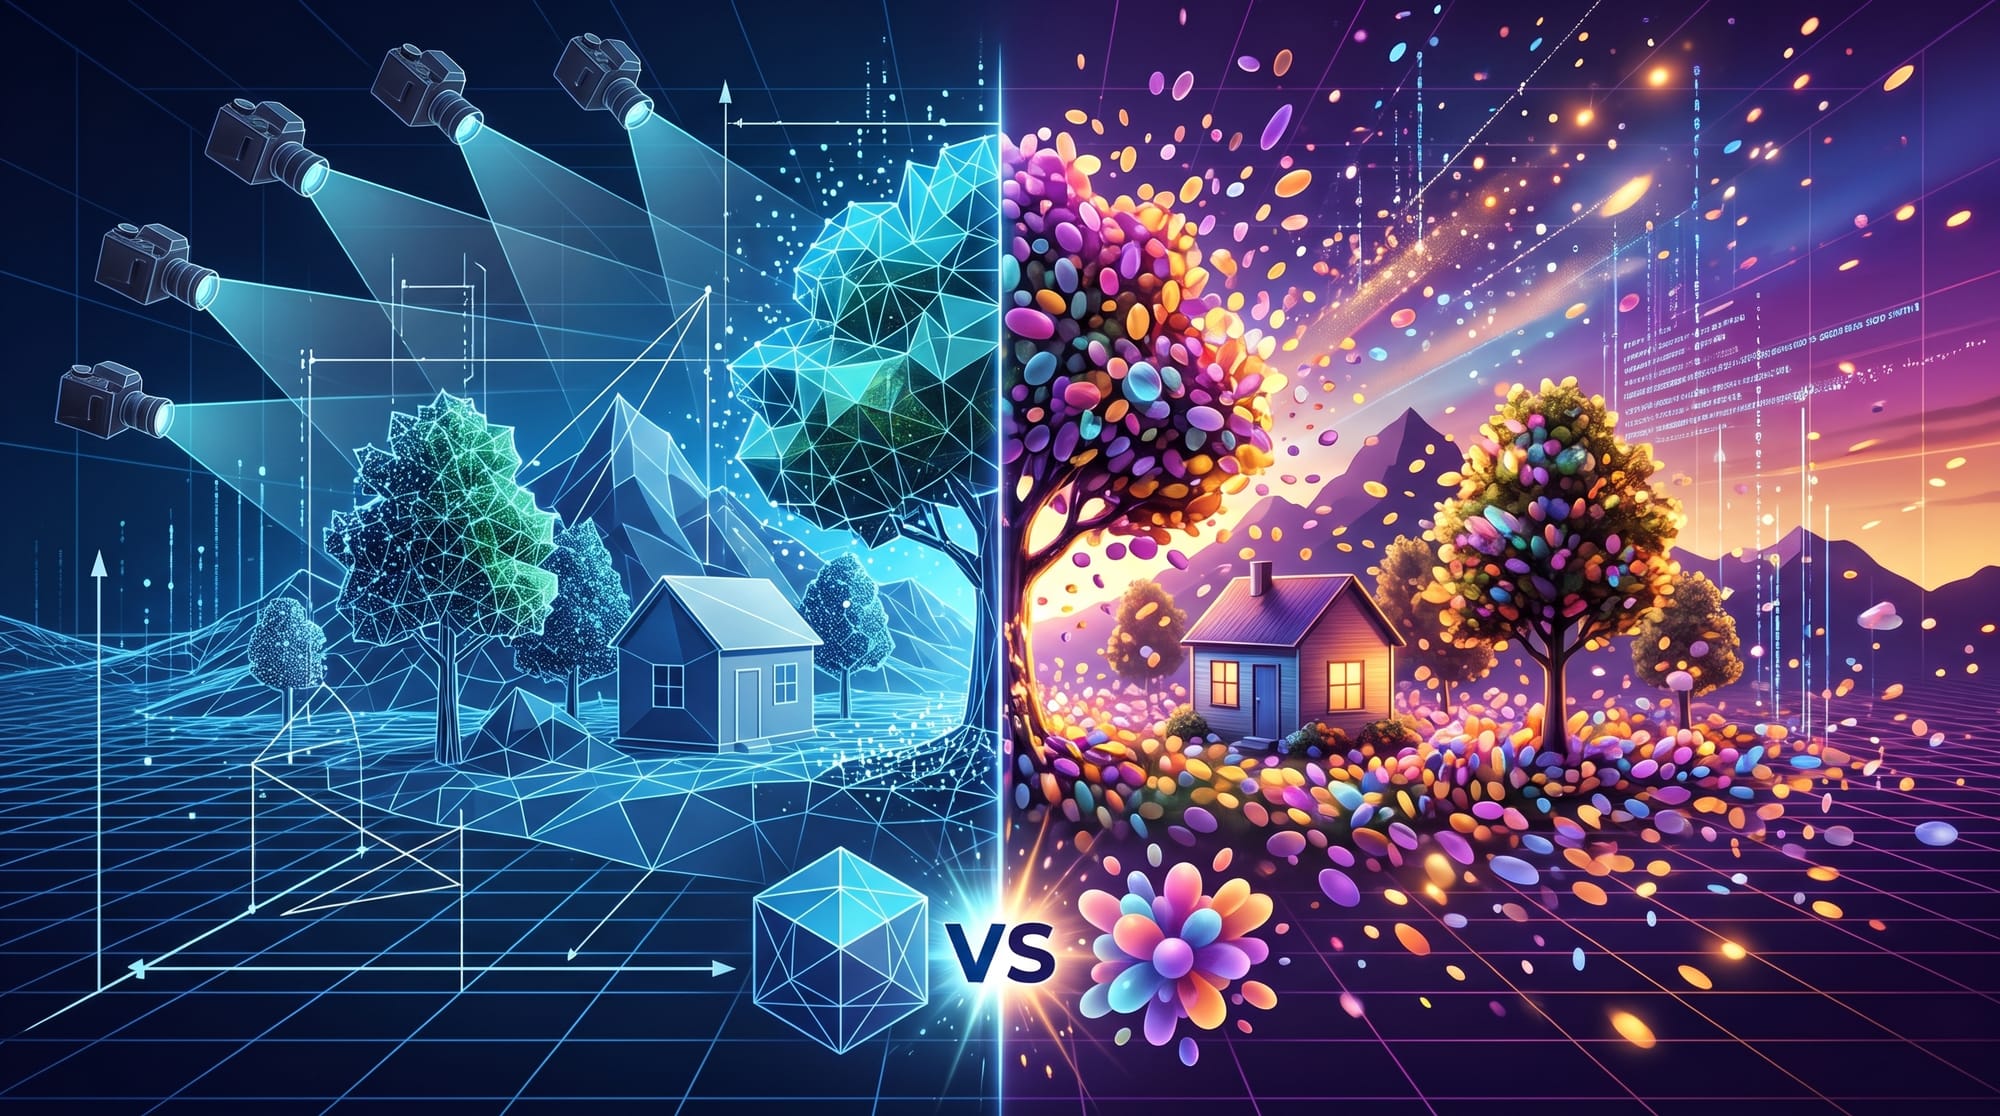
3DGSとフォトグラメトリは、どちらも複数の写真から3D空間を再構成する技術です。本記事では、SfMによるカメラ位置・姿勢推定やSparse Point Cloudまでの共通点と、その後にフォトグラメトリがMVS・Dense Point Cloud・メッシュ生成へ進み、3DGSがGaussianの初期化・最適化へ進む違いを整理して解説します。
目次
前回の記事では、3DGSと従来の3Dメッシュとの違いについて解説しました。
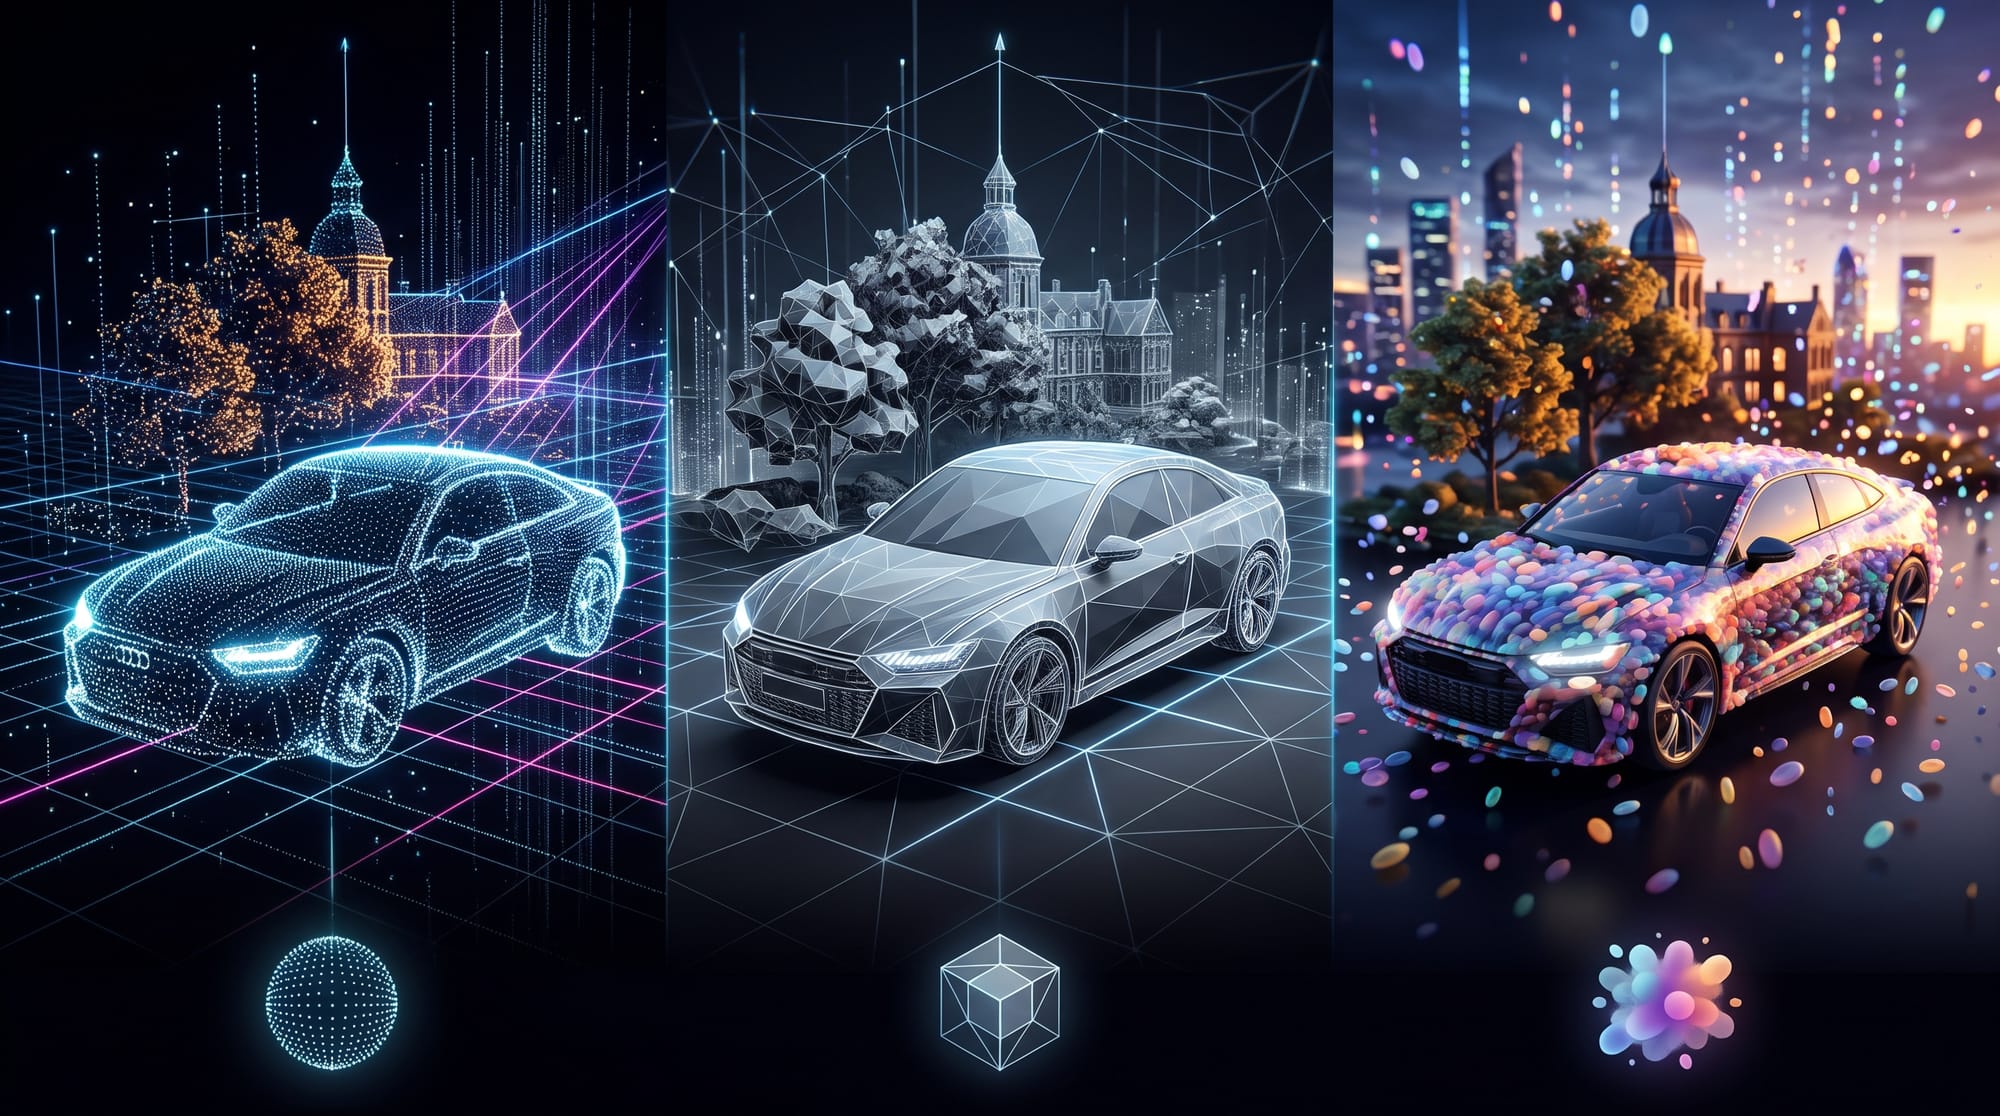
簡単におさらいすると、3Dメッシュとは、頂点と面を組み合わせて立体の形状を表現する方法です。その表面にテクスチャを貼り付けることで、色や模様、質感などを再現します。
ゲームや映像制作などで使われる一般的な3Dモデルの多くは、このメッシュによって作られています。従来の3D制作では、3Dモデラーと呼ばれる専門家が、Blenderなどの専用ツールを使って形状や質感を作り込んでいきます。
一方、3DGSは、複数の写真から現実の空間を再構成し、Gaussian(ガウシアン)と呼ばれる小さな要素を大量に配置することで、写真に近い見た目の3D空間を表現する技術です。
ただし、複数の写真から現実の空間を3D化する技術は、3DGSが初めてではありません。
その代表例が、フォトグラメトリ(Photogrammetry)です。
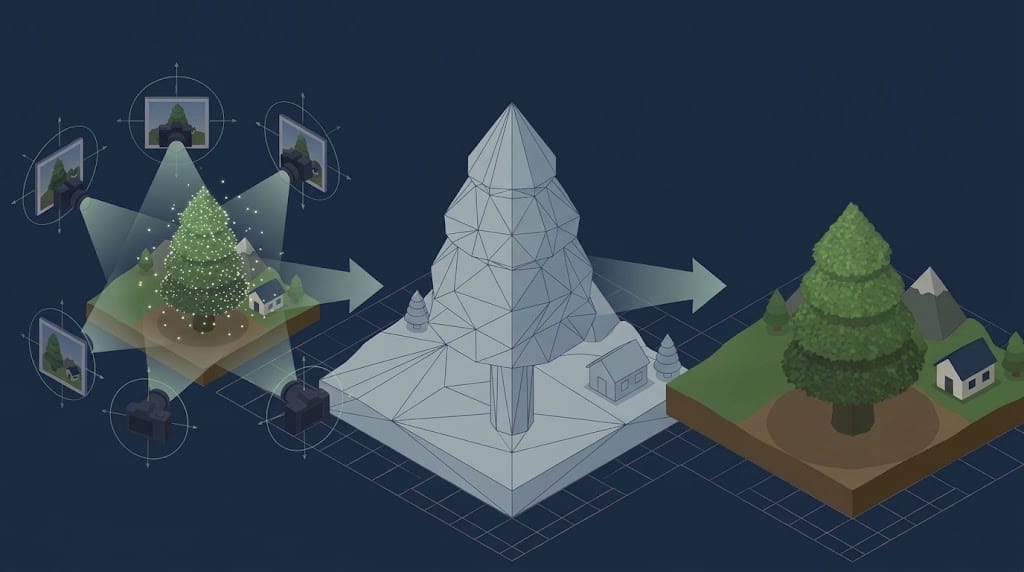
フォトグラメトリは、複数の写真を解析して、被写体の形状やカメラの位置関係を推定し、3Dモデルを生成する技術です。
そして、一般的なフォトグラメトリでは、最終的にテクスチャ付きのメッシュが生成されます。
つまり、フォトグラメトリは写真から3Dモデルを自動生成する技術ですが、その成果物は、前回紹介した従来型のメッシュによる3Dモデルと同じような構造をしています。
では、3DGSとフォトグラメトリは、まったく異なる技術なのでしょうか?
実は、そうではありません。
両者には共通する処理があります。特に、複数の写真からカメラの位置や向きを推定する最初の段階では、よく似た処理が行われます。
では、どこまでが共通していて、どこから違いが生まれるのでしょうか。
今回は、フォトグラメトリの基本的な仕組みを振り返りながら、3DGSとの共通点と違いを見ていきます。
まずはフォトグラメトリの処理を概観
フォトグラメトリは、複数の写真から被写体や環境の3D形状を復元する技術です。
例えば、ある建物をさまざまな方向から撮影し、その写真を解析することで、建物の3Dモデルを生成できます。
一般的な処理の流れは次のようになります。
- 複数の視点から写真を撮影する
- 写真同士の特徴点を対応付ける
- カメラの位置・姿勢を推定する
- Sparse Point Cloudを生成する
- Dense Point Cloudを生成する
- メッシュとテクスチャを生成する
ここで重要になるのが、SfM(Structure from Motion)とMVS(Multi-View Stereo)という2つの処理です。
SfM:写真からカメラの位置と3D構造を推定する
SfMは、複数の写真に写っている特徴点を対応付け、それらの情報からカメラの位置・姿勢と、特徴点の3D座標を推定する技術です。
例えば、ある壁の模様が複数の写真に写っていたとします。
その模様が各写真のどこに写っているかを調べることで、写真同士の位置関係を推定できます。
さらに、複数の写真の対応関係を利用することで、撮影時のカメラ位置や姿勢、特徴点の3D位置を求めます。
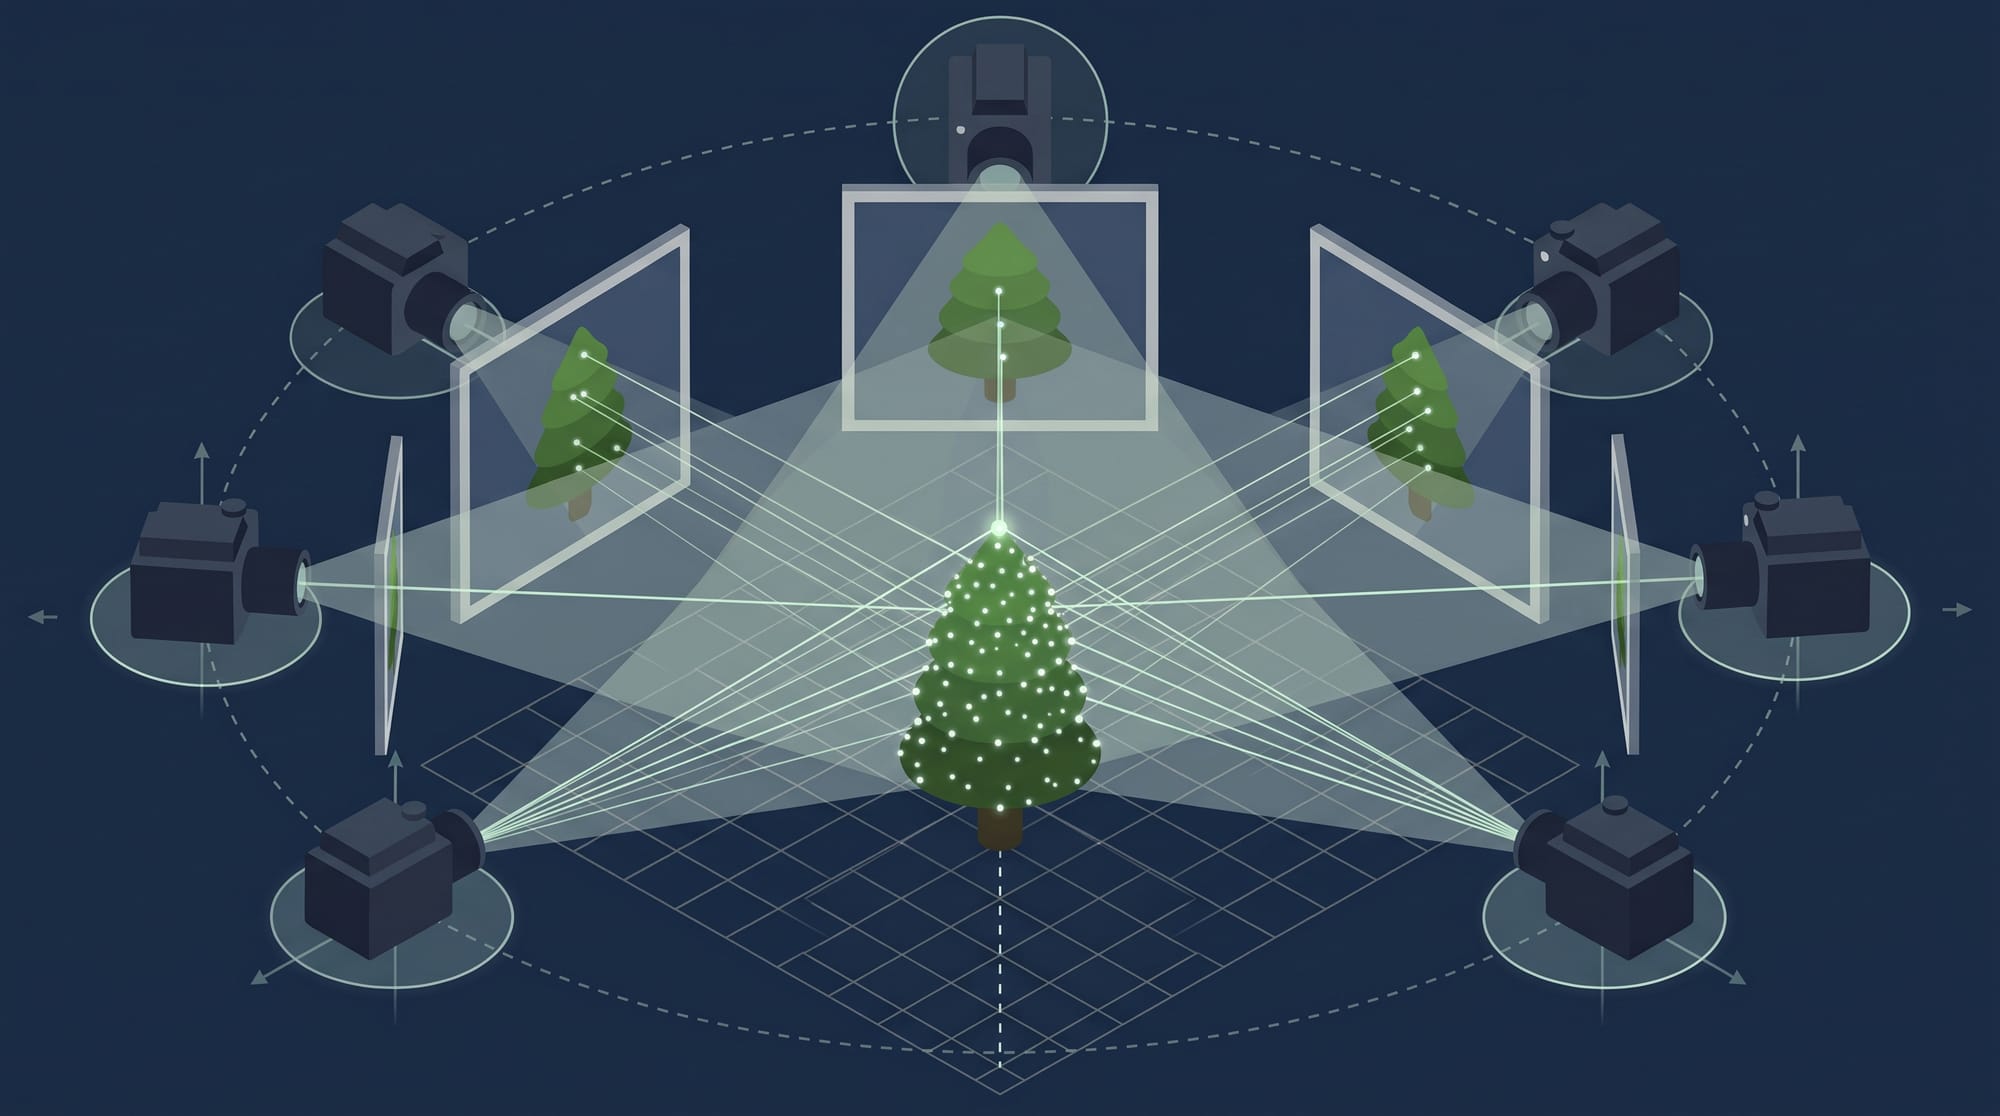
この処理によって得られるものが、カメラの位置・姿勢情報とSparse Point Cloudです。
Sparse Point Cloudは、特徴点を中心とした疎な点群です。まだ物体の表面全体を表現できるほど密な点群ではありません。
MVS:複数の写真から密な3D形状を復元する
SfMでカメラの位置・姿勢が求まったら、次はMVSです。
MVSでは、カメラの位置関係が分かっている複数の写真を使い、各画素に対応する3D位置を推定します。
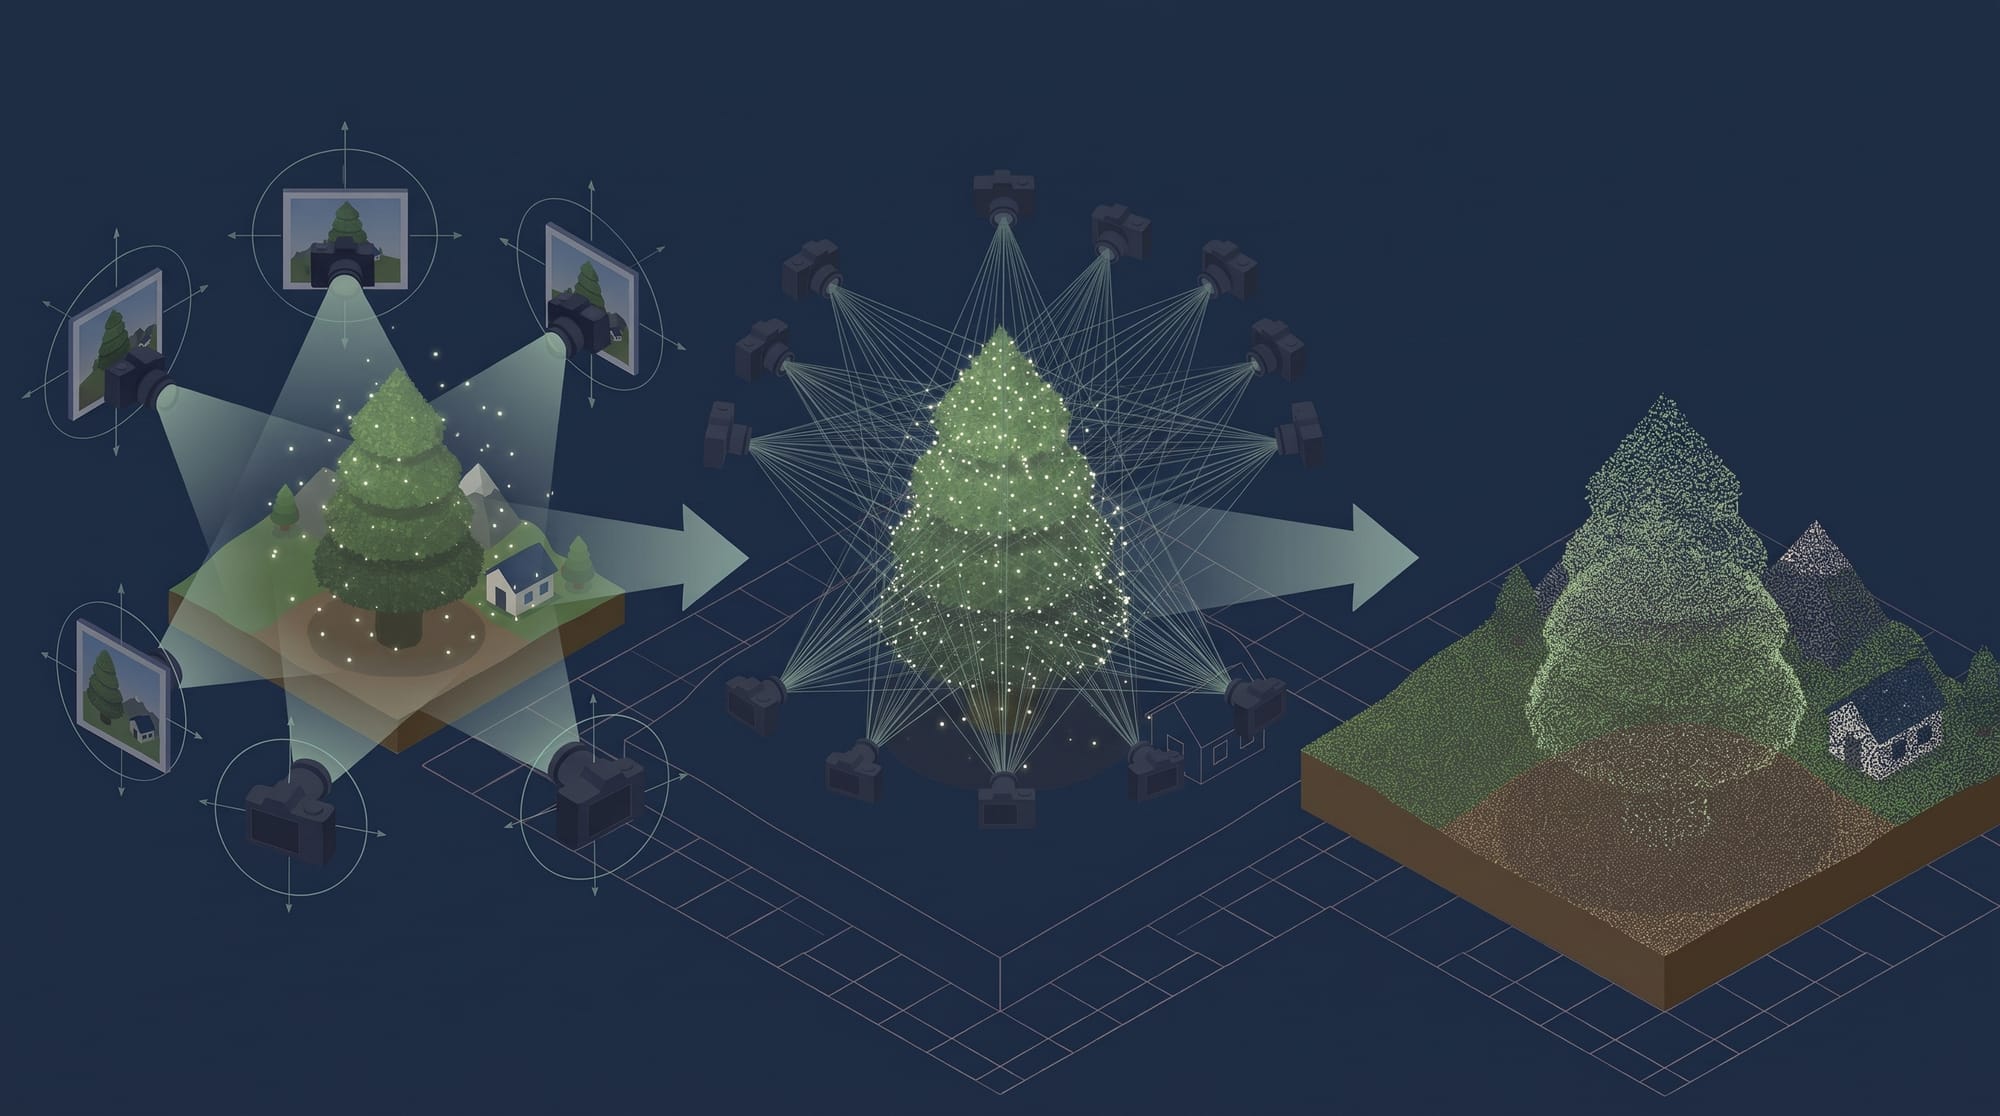
これによって、Sparse Point Cloudよりも密なDense Point Cloudを生成できます。
その後、点群からメッシュを生成し、テクスチャを貼り付けることで、一般的なフォトグラメトリの3Dモデルが完成します。
つまり、フォトグラメトリでは、写真からカメラ位置と疎な3D構造を求め、さらに密な形状を復元していくわけです。
実は3DGSもSfMから始まる
ここで3DGSの処理を見てみましょう。
3DGSも、基本的には複数の写真を入力として使用します。
そして、多くの標準的な3DGSのワークフローでは、最初にSfMを実行します。
つまり、フォトグラメトリと同じように、写真同士の特徴点を対応付け、カメラの位置・姿勢を推定します。
さらに、SfMによって得られたSparse Point Cloudも利用します。
ここが重要なポイントです。
3DGSは、フォトグラメトリとまったく別の方法で3D空間をゼロから構築するわけではありません。
少なくとも一般的な3DGSのパイプラインでは、SfMによって得られたカメラ情報や点群を出発点として、その後の処理を進めます。
実際に、代表的な3DGSの実装ではCOLMAP(※1)によるSfMの結果を入力として利用できます。
※1: COLMAPは、SfMやMVSを実行できるオープンソースのソフトウェア。フォトグラメトリでも広く利用されています。
SfMの後で、フォトグラメトリと3DGSは分岐する
では、SfMが終わった後はどうなるのでしょうか?
ここから両者のアプローチが大きく変わります。
フォトグラメトリでは、一般的にMVSによって密な点群を生成し、そこからメッシュやテクスチャを作ります。
一方、3DGSではSparse Point Cloudなどを初期値として、Gaussianを配置・最適化していきます。
Gaussianとは、簡単に言うと、3D空間に配置される小さな楕円体状の表現要素です。
それぞれのGaussianは、位置や大きさ、向き、透明度、色などの情報を持っています。
これらを大量に配置し、入力写真に近い画像が再現できるように最適化することで、3DGSのシーンが生成されます。
両者の処理を簡略化して比較すると、次のようになります。
フォトグラメトリ
写真撮影
↓
SfM(カメラ位置・姿勢の推定)
↓
Sparse Point Cloud
↓
MVS
↓
Dense Point Cloud
↓
Mesh生成
↓
Texture生成
3DGS
写真撮影
↓
SfM(カメラ位置・姿勢の推定)
↓
Sparse Point Cloud
↓
Gaussianの初期化
↓
Gaussianの最適化
↓
3D Gaussian Sceneの生成
このように、最初のSfMまでは共通する部分が多いものの、その後の3D空間の表現方法と最適化の考え方が異なります。
生成されるデータは何が違うのか
ここで、生成されるデータの違いについても整理しておきましょう。
冒頭に触れた通り、フォトグラメトリで生成される成果物は基本的に、一般的な3Dモデリングソフトで扱われるモデルと同様の3Dメッシュです。
明確な面を持ち、その上にテクスチャを貼り付けることができます。
それに対して3DGSの描画単位は細かい粒で、さらに空間的な広がりを持っており、位置・形状・色・透明度などを使ってシーンを表現します。
ここで注意したいのは、3DGSのGaussianが必ずしも物体の正確な表面を表しているわけではないということです。
3DGSは、入力された写真を別の視点からできるだけ自然に再現することを重視した表現です。
そのため、見た目は非常にリアルでも、そこから取り出した形状が必ずしも正確な3Dモデルになるとは限りません。
この点は、従来のフォトグラメトリとの大きな違いの一つです。
3DGSはフォトグラメトリの代替技術なのか?
ここまでの話を踏まえると、3DGSはフォトグラメトリの代替技術なのでしょうか?
答えは、用途によります。
例えば、次のような用途では3DGSが有力な選択肢になります。
- 実写空間を高品質に再現したい
- 自由な視点からシーンを閲覧したい
- 写真に近い見た目を重視したい
- リアルタイムに近い描画を実現したい
一方で、次のような用途では従来のフォトグラメトリによるメッシュ生成が適している場合があります。
- 寸法や形状を正確に計測したい
- CADや3Dモデリングの素材として使いたい
- 物理シミュレーションに利用したい
- 一般的な3Dモデルとして編集・加工したい
もちろん、3DGSからメッシュを生成する研究や技術も進んでいます。
ただし、3DGSで得られるシーンと、従来のフォトグラメトリで得られるメッシュモデルは、そもそも目指しているものが異なります。
単純にどちらが優れているかという比較ではなく、何を3Dとして表現したいのかによって使い分けることが重要です。
まとめ
今回は、3DGSとフォトグラメトリの関係について解説しました。
重要なポイントを整理すると、次の3つです。
- 3DGSとフォトグラメトリは、複数の写真からカメラ位置・姿勢を推定するSfMの段階で共通する部分が多い。
- SfMの後は、フォトグラメトリがMVSによる密な形状復元やメッシュ生成に進むのに対し、3DGSはGaussianの初期化と最適化に進む。
- フォトグラメトリが主に幾何形状の復元を目指すのに対し、3DGSは写真の見た目を高品質に再現することを重視する。
3DGSは、従来のフォトグラメトリとはまったく無関係な技術ではありません。むしろ、SfMなどの既存技術を土台として、新しい3D表現と描画の仕組みを組み合わせた技術と考えると理解しやすいでしょう。
次回は、3DGSと2DGS、そしてNeRFの違いについて解説します。それぞれがどのような3D表現を採用し、何を得意としているのかを見ていきましょう。
1,000社以上の事業成長を支えた圧倒的な『スピードと柔軟性』で、御社のアイデアを最短で形にします。まずは無料で壁打ちしませんか?