AIは「教わる」から「試す」へ、なぜ学習方法を切り替えられるのか
AIは、人間のお手本を真似する模倣学習から、自分で試行錯誤する強化学習へ移行できます。本記事では、両者が同じモデルの行動確率を調整する学習としてつながる理由、なぜ模倣学習を先に行うと有効なのか、切り替え時に起こる失敗や対策、ロボットや対話AIでの応用まで整理します。
目次
「教わる」と「試す」は、本当に別の学習なのか
人間にとって、「本で勉強すること」と「実際にやってみて体で覚えること」は、かなり違う学習に感じます。
ロボットに料理をさせる場合も同じです。人間がやっているところを見せて覚えさせる方法と、何度も失敗させながら上達させる方法は、まったく別の訓練に見えます。
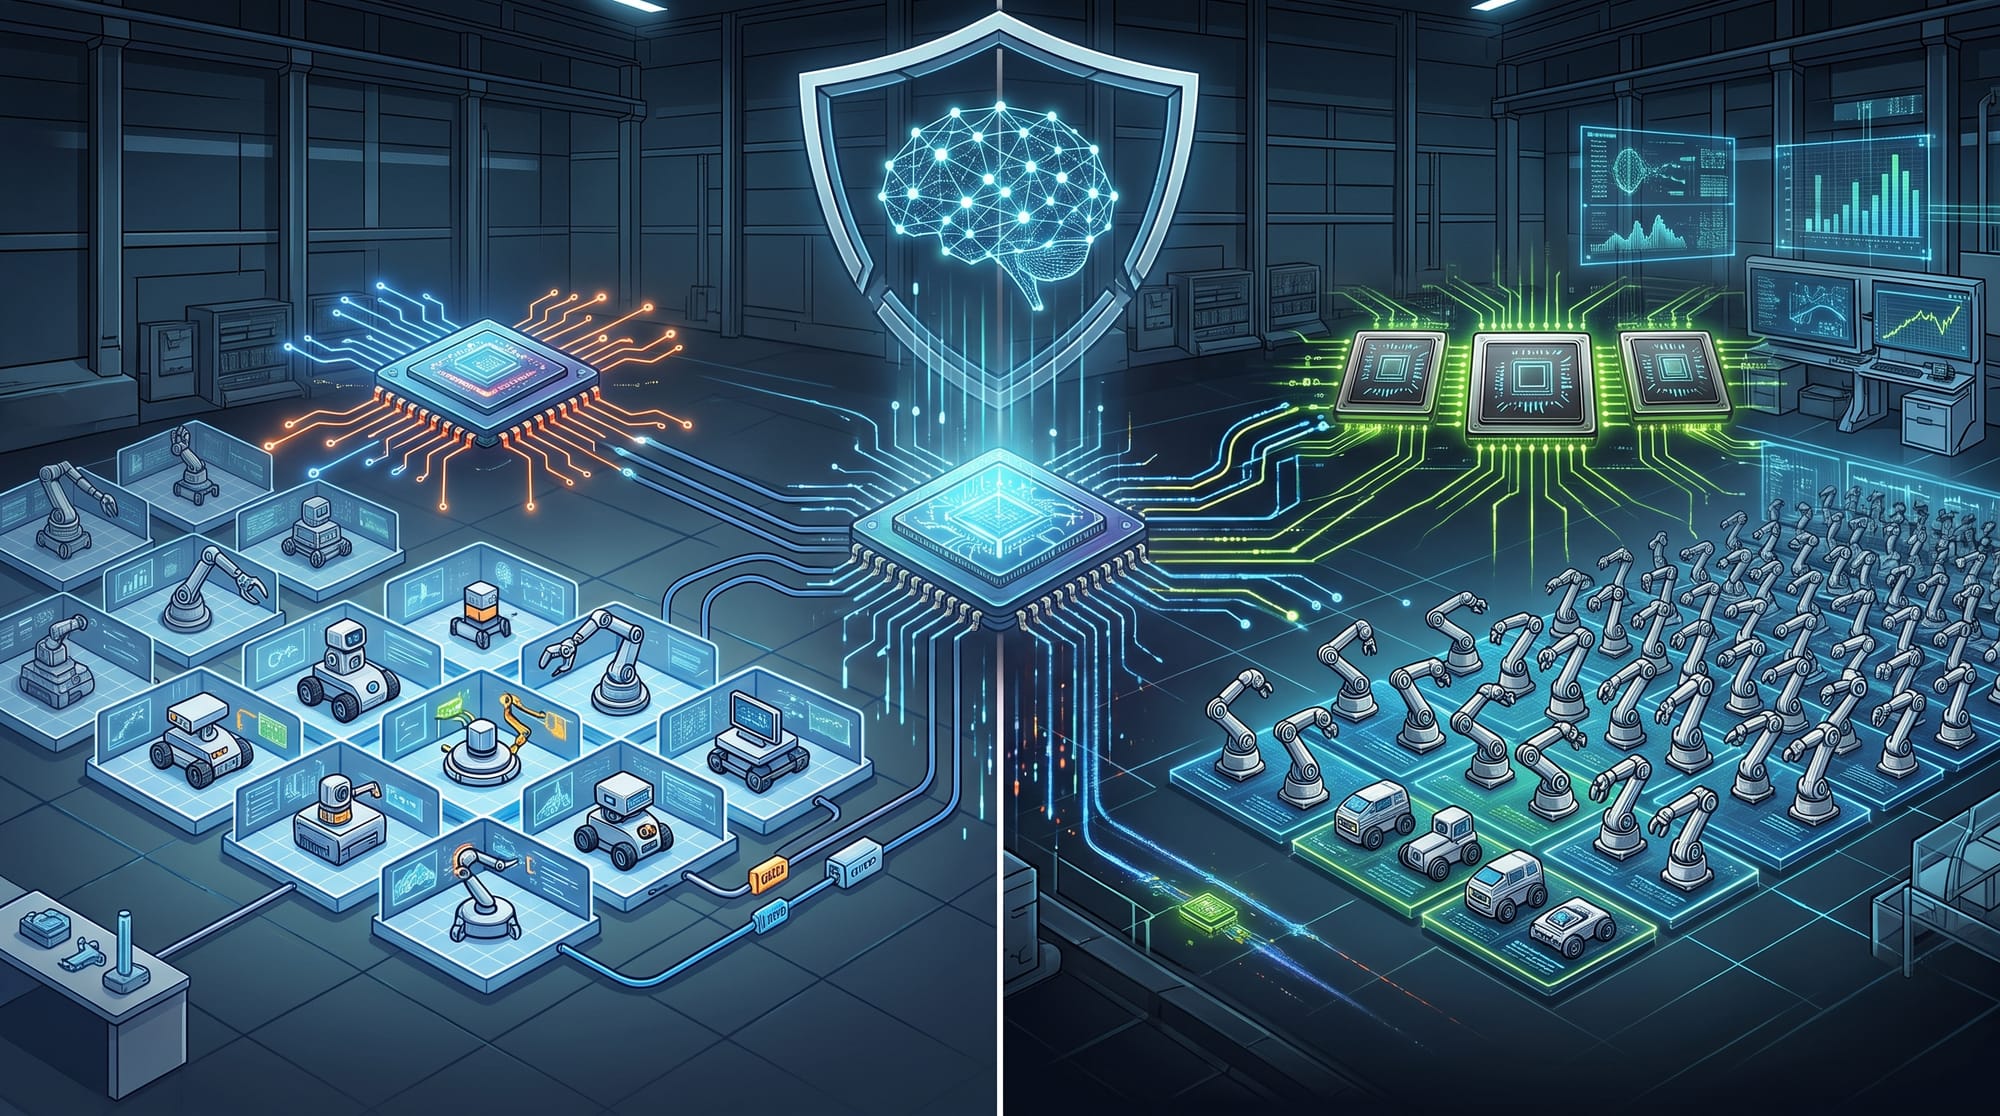
ところがAIでは、この二つを同じAIに対して続けて行うことができます。まず人間のお手本を真似させ、途中からは自分で試行錯誤させる。しかも、真似で身につけた能力を土台にしたまま、です。
なぜ、こんな切り替えができるのでしょうか。よく「どちらもAIの中身を調整する作業だから」と説明されますが、それだけでは答えになっていません。それなら、どんな学び方同士でも自由につなげられることになってしまいます。
この記事では、もう一歩踏み込んで、次の三つの問いを考えます。
- なぜ「真似」と「試行錯誤」は、一つのAIの中でつながるのか
- なぜ「先に真似、後で試行錯誤」という順番がうまくいくのか
- 切り替えるときに、どんなつまずきが起きるのか
前提:AIの「学習」とは、何を変えることなのか
ロボットを動かすAIは、目の前の状況を受け取って、次にどう動くかを決める仕組みです。
ここで大事なのは、AIが動きを一つに決め打ちしているわけではない、という点です。「この状況なら、右に動かすのが7割、少し待つのが2割、左が1割」というように、動きごとの「出やすさ」を持っています。サイコロに重りがついていて、出やすい目と出にくい目がある、とイメージしてください。
AIの中には、この重りのつき方を決める調整つまみが膨大にあります。学習とは、このつまみを少しずつ回して、どの動きを出やすくし、どの動きを出にくくするかを変えていくことです。
すると、最初の問いはこう言い換えられます。「真似」と「試行錯誤」は、それぞれどの動きを出やすくしようとしているのか。そして、そこに共通点はあるのか。
まず真似させる:模倣学習
ロボットアームに「コップをつかんで持ち上げる」仕事を覚えさせるとします。何も知らないロボットに「成功したらご褒美をあげる」とだけ伝えても、最初はほとんど成功しません。
そこで、人間がロボットを遠隔操作して、お手本の動きをたくさん記録します。「この景色が見えたとき、人間はアームをこっちに動かした」という記録です。
AIはこの記録を見ながら、「人間がとった動き」が出やすくなるように、つまみを回していきます。これが模倣学習です。
この段階のAIは、「なぜその動きが良いのか」を理解しているわけではありません。ただ、「こういう場面では、こう動くものだ」という基本の型を身につけます。スポーツで、まずコーチのフォームを真似するのに似ています。
次に試させる:強化学習
強化学習では、お手本を見せません。代わりにAI自身に動かしてみて、その結果に点数をつけます。
- コップをつかめた → 高い点
- コップを落とした → 低い点
- 目的地まで運べた → さらに高い点
- 必要以上に時間がかかった → 少し減点
AIは、いつもより点が良かった動きは出やすく、点が悪かった動きは出にくくなるように、つまみを回していきます。うまくいったことは増やし、失敗したことは減らす、という素直な仕組みです。
ここで注意したいのは、AIが目指すのはあくまで点数だという点です。速く動いてほしければ時間を点数に入れる必要がありますし、電気を節約してほしければ消費電力を入れる必要があります。AIにとっての「上達」は、点数のつけ方で決まります。
核心:二つの学習は、同じことをしている
ここで、二つの学習を並べてみます。
模倣学習 | 強化学習 | |
|---|---|---|
出やすくする動き | 人間がとった動き | 自分が試して、うまくいった動き |
出にくくする動き | (特になし) | 自分が試して、失敗した動き |
何を手がかりにするか | お手本 | 結果の点数 |
見比べると、やっていることの中身は同じです。どちらも「ある動きを、出やすくしたり出にくくしたりする」ために、同じつまみを回しています。違うのは、どの動きを選ぶかの基準だけです。
言い換えると、模倣学習は「人間の動きは全部うまくいった動きだった、とみなした試行錯誤」です。反対に強化学習は、「うまくいった自分の動きをお手本にする真似」だとも言えます。
料理にたとえてみましょう。レシピ通りに作るのも、味見しながら調整するのも、最終的には同じ「自分の作り方のクセ」を少しずつ変えています。手がかりがレシピか、自分の舌か、の違いです。だから、レシピで基本を覚えた人が、そのまま味見による調整に移っても、何も矛盾しません。
AIでも同じです。真似から試行錯誤への切り替えは、別の装置に乗り換えることではありません。同じつまみを回しながら、「どの動きを増やすか」の基準を、お手本から結果へと入れ替えているだけなのです。これが、二つの学習がつながる本当の理由です。
なぜ「先に真似、後で試行錯誤」なのか
つまみを回す作業は、いつも「今のつまみの位置」から続きを始めます。それまでの調整がお手本によるものだったか、点数によるものだったかは関係ありません。ですから、真似で調整したAIは、そのまま試行錯誤の出発点になります。
では、なぜ出発点がそれほど大事なのでしょうか。理由は、試行錯誤という学び方そのものにあります。
試行錯誤は、「たまたまうまくいった動き」を見つけて、それを増やしていく学び方です。ところが、何も知らないロボットがでたらめに動いて、コップをつかんで運べることはほぼありません。一度も成功しなければ、何を増やせばいいのか分からず、学習は進みません。
真似を済ませたAIは、最初から「そこそこうまくいく動き」が出やすくなっています。そのため試行錯誤を始めた直後から、成功と失敗が適度に混ざり、比べながら改善できます。模倣学習は、試行錯誤がいちばん苦手な「最初の成功を見つける」部分を引き受けているのです。
一方で、試行錯誤を加える意味もあります。人間のお手本は、必ずしも最善ではありません。点数のつけ方次第では、AIは人間より速い動きや、人間が思いつかない動きを見つけることがあります。お手本にはなかった場面での立て直し方も、試行錯誤から学べます。
ただし、切り替えにはつまずきもある
やっていることが同じなら、何も考えずに切り替えればよいのでしょうか。実際には、切り替えた直後にいくつかのつまずきが起こります。どれも人間の学びに置き換えると、意外と身近な話です。
自己採点の感覚が、まだ育っていない
試行錯誤で上達するには、「今のは良かったのか、悪かったのか」を見分ける感覚が必要です。ところが真似の段階では、お手本に従っていただけなので、この感覚は育っていません。
そのため、試行錯誤に移った直後は、良い動きを減らし、悪い動きを増やすような的外れな調整が起こりがちです。せっかく覚えた動きが、かえって下手になることもあります。そこで実際には、しばらく動きは変えずに「良し悪しを見分ける感覚」だけを先に鍛えてから、本格的な試行錯誤に入る、といった工夫がされます。
お手本になかった場面に迷い込む
真似の段階では、人間が経験した場面しか見ていません。試行錯誤を始めると、AIの動きが人間から少しずつずれ、お手本には一度も出てこなかった場面に入り込みます。
教習所のコースでは運転できても、初めての道で戸惑うのと同じです。対策として、人間のお手本を捨てずに、試行錯誤の経験と混ぜて学び続ける方法がよく使われます。
点数を追うあまり、元の良さを失う
AIの目標は点数を上げることであって、人間らしく動くことではありません。試行錯誤を続けるうちに、お手本の動きから大きく離れていくことがあります。
それ自体は悪いことではありません。しかし点数のつけ方に抜け穴があると、その穴を突く奇妙な動きに落ち着いてしまうこともあります。お手本が持っていた「常識的な動き方」は、点数には書かれていないからです。
そこで、「元の動きから離れすぎたら減点する」というルールを加えることがあります。ゴムひもで元の動きにつないでおき、自由に改善させつつも、遠くへは行かせないイメージです。
「切り替え」より「配合を変える」
こうした工夫を見ると、「真似から試行錯誤に切り替える」という言い方自体が、少し実態とずれていることに気づきます。
実際には、お手本を手がかりにする学びと、結果を手がかりにする学びを、両方とも混ぜて使い続けることが多いのです。最初はお手本の比重を大きくし、少しずつ結果の比重を増やしていく。二つが同じつまみを回す学びだからこそ、こうした混ぜ合わせが自然にできるのです。
同じ構造は、対話AIにもある
この「真似してから試行錯誤する」流れは、ロボットに限った話ではありません。ChatGPTやClaudeのような対話AIも、ほぼ同じ流れで育てられています。
- 大量の文章を読んで、言葉のつながり方を身につける
- 人間が書いた理想的な受け答えを真似する
- 返答の良し悪しに点数をつけて、試行錯誤で磨く
対話AIも、「次にどの言葉が出やすいか」というサイコロを持っています。だから真似も試行錯誤も、「どの言葉を出やすくするか」を調整する同じ作業になります。この記事で見てきた構造そのものです。
さらに、試行錯誤の段階では「元のAIから離れすぎない」ための工夫も使われます。点数だけを追いかけると、評価の抜け穴を突いた不自然な文章を書き始めることがあるからです。ロボットで起きることと、まったく同じことが起きているわけです。
補足:試行錯誤はどこでやるのか
ロボットの試行錯誤には、もう一つ現実的な問題があります。失敗のたびに本物のロボットが動くので、壊れたり、転んだり、人にぶつかったりする危険があります。時間もかかります。そのため、コンピューターの中に作った仮想の世界(シミュレーション)で、何百万回も練習させるのが一般的です。
ただし、仮想の世界は現実と完全には一致しません。床の滑りやすさや物の重さが少し違うだけで、仮想世界では成功した動きが現実では失敗することがあります。そこで、練習のたびに滑りやすさや重さをわざと変えて、多少の違いには動じない動き方を身につけさせる、といった工夫がされます。
これは「どこで練習するか」の話で、この記事のテーマである「なぜ学び方を切り替えられるか」とは別の問題です。ただ、「お手本になかった場面に迷い込む」という悩みとは根が同じです。人間のお手本から自分の経験へ、仮想世界から現実へと、学ぶ材料が変わるたびに、そのずれへの対処が必要になるのです。
まとめ:「教わる」と「試す」は、同じ営みの二つの顔
冒頭の三つの問いに、改めて答えます。
- なぜつながるのか。 真似も試行錯誤も、「ある動きを出やすくしたり、出にくくしたりする」という同じ調整をしているからです。違うのは、何を手がかりに動きを選ぶか(お手本か、結果か)だけです。
- なぜ真似が先なのか。 調整はいつも今の状態から続きを始めるので、真似で身につけた型が、そのまま試行錯誤の出発点になります。特に、試行錯誤が苦手な「最初の成功を見つける」部分を、真似が引き受けてくれます。
- どんなつまずきがあるのか。 良し悪しを見分ける感覚がまだないこと、お手本になかった場面に迷い込むこと、点数を追うあまり元の良さを失うことです。そのため実際には、二つの学びを混ぜながら、少しずつ比重を移していきます。
人間から見ると、「お手本を真似すること」と「自分で試して上達すること」は、まったく別の学び方に見えます。しかしAIの中では、両者は同じ営みの二つの顔にすぎません。
AIの学習で本当に大事なのは、学び方を「切り替える」ことではありません。お手本と結果という性質の違う手がかりを、同じ調整の材料として使えること。そして、その配合を成長の段階に合わせて変えていけることなのです。
1,000社以上の事業成長を支えた圧倒的な『スピードと柔軟性』で、御社のアイデアを最短で形にします。まずは無料で壁打ちしませんか?