RAG は「区切って、ベクトルにして、近いものを選ぶ」だけ。だからなんでも RAG にしなくていい
社内の資料を AI に答えさせたい、と言うと決まって出てくる RAG。中身は「文書を区切ってベクトルにし、質問に近い断片を選んで AI に渡す」検索のしくみです。しくみが分かると、得意なこと・苦手なことと、RAG を使わないほうがよい場面が見えてきます。架空の社内規程を例に整理します。
目次
社内の資料を AI に読ませて、質問に答えさせたい。この相談をすると、たいてい「それなら RAG ですね」という答えが返ってくる、そんな経験はあるのではないでしょうか
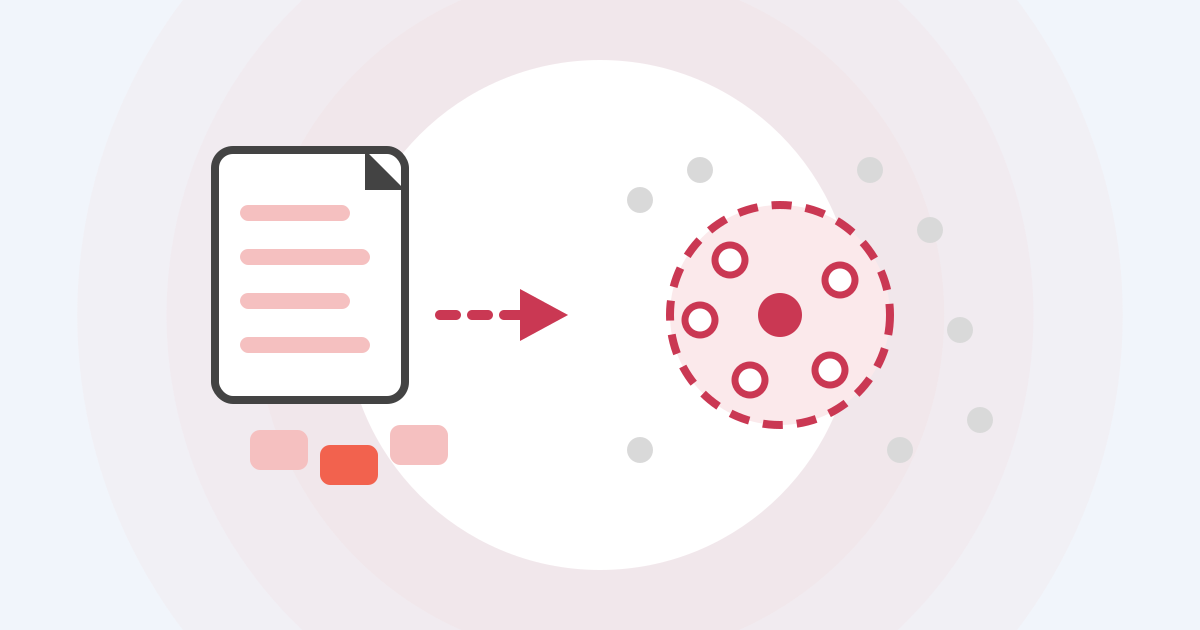
RAG(Retrieval-Augmented Generation、検索拡張生成)は、名前のわりに中身は素朴です。文書を細かく区切り、それぞれを数値の列(ベクトル)にしておき、質問に近い断片をいくつか選んで AI に渡す。やっていることはこれだけです。
素朴だからこそ、得意なことと苦手なことがはっきりしています。この記事では、架空の社内規程を例に RAG の中身を順に追い、RAG が向かない場面と、そのときの代わりの方法を整理します。
この記事の要点
- RAG は「AI の頭を良くする技術」ではなく「AI に渡す資料を選ぶ検索のしくみ」です。答えの質は、選ばれた断片の質で決まります。
- 「近い断片」を選ぶので、件数を数える、全体を比べる、最新の数字を出す、といった質問は苦手です。
- 資料が少なければ全部 AI に渡せばよく、数字なら DB に問い合わせればよい。RAG は選択肢の1つです。
RAG がやっていること:4つの手順
例として、社員300人の会社の「就業規則・経費規程・出張規程」(PDF で合計80ページ)を AI に答えさせる場合を考えます。
1. 区切る(チャンク分割)
まず文書を、数百文字ほどの断片(チャンク)に切ります。80ページなら、数百個の断片になります。
切り方には決まった正解がありません。文字数で機械的に切る、見出しごとに切る、前後を少し重ねて切る、などの方法があり、ここで答えの質が大きく変わります。「第12条 出張旅費」の見出しと、その下の「ただし、役員を除く」が別の断片に分かれると、後の手順で片方しか選ばれないことがあります。
2. ベクトルにする(埋め込み)
次に、断片ごとに 埋め込み(embedding) と呼ばれる数値の列を作ります。埋め込み用のモデルに文章を渡すと、数百〜数千個の数値が返ってきます。意味の近い文章ほど、数値の列も近くなるように作られています。
たとえば「出張の日当はいくら?」と「国内出張の日当は1日2,000円とする」は、言葉は違っても近い数値になります。ここが、キーワードが一致しないと見つからない従来の全文検索との違いです。
作った数値の列は、ベクトルデータベースに断片の本文と一緒に保存しておきます。
3. 近いものを選ぶ(検索)
ユーザーが質問すると、質問文も同じモデルで数値の列にします。そして、保存してある数百個の断片の中から、質問と数値が近い順に上位いくつか(たとえば5個)を選びます。
近さは「2つの数値の列がどれだけ同じ向きを向いているか」で測ります。
意味を理解して選んでいるのではなく、数値の近さで機械的に選んでいます。
4. 渡して答えさせる(生成)
最後に、選ばれた5個の断片と質問をまとめて AI に渡し、「この資料にもとづいて答えて」と頼みます。AI が見るのは、この5個の断片だけです。80ページの規程を AI が全部読んでいるわけではありません。
しくみから分かる、RAG の苦手なこと
AI が見るのは「質問に近い数個の断片」だけ。この一点から、苦手な質問が見えてきます。
| 質問の例 | なぜ苦手か |
|---|---|
| 「規程の中で、上長の承認が要る手続きを全部挙げて」 | 該当箇所が数十か所に散らばっていても、渡せるのは上位数個だけ |
| 「経費規程と出張規程で、宿泊費の上限が違うのはなぜ?」 | 2つの文書をまたいで比べるには、両方の該当箇所が選ばれている必要がある |
| 「先月の経費精算は何件?」 | 件数や合計は文書ではなく業務システムのデータにある |
| 「この規程、全体として何が言いたいの?」 | 要約には全体が要るが、渡されるのは一部だけ |
| 「第12条の例外は?」 | 「第12条」のような番号や型番は、意味の近さでは拾いにくい |
逆に、RAG が得意なのは「答えが資料のどこか1〜2か所に書いてある」質問です。「出張の日当はいくら?」「育休は何日取れる?」のような、いわゆる社内 FAQ はこれに当たります。
もう1つ、よく誤解される点があります。RAG は AI が「嘘をつかなくなる」技術ではありません。関係のない断片が選ばれれば、AI はその断片をもとにもっともらしい答えを作ります。答えの横に「どの断片を根拠にしたか」を出して、人が確かめられるようにするのが普通です。
RAG を使わないほうがよい場面と、代わりの方法
資料が少ないなら、全部渡す
いまの AI は、一度にかなりの量の文章を読めます。Anthropic は RAG の改良手法を紹介した記事の中で、次のように書いています。
If your knowledge base is smaller than 200,000 tokens (about 500 pages of material), you can just include the entire knowledge base in the prompt that you give the model, with no need for RAG or similar methods.
(訳)知識ベースが20万トークン(資料にして約500ページ)より小さければ、知識ベース全体をモデルへのプロンプトに入れればよく、RAG のような方法は要りません。
— Anthropic「Introducing Contextual Retrieval」(2024年9月)
例の80ページの規程なら、区切らずに全部渡せます。全体を読んでいるので、「全部挙げて」「比べて」「要約して」にも答えられます。同じ資料を何度も渡す費用は、プロンプトのキャッシュ機能で抑えられます。
数字や一覧なら、データベースに聞く
「先月の経費精算は何件?」の答えは、文書ではなく経費精算システムのデータベースにあります。この場合は、AI に SQL や API の呼び出しを組み立てさせて、データベースに直接問い合わせるほうが確実です。文書にした月次レポートを RAG で探すと、古い月の数字を拾うおそれがあります。
決まった形の質問なら、普通の検索や FAQ で足りる
型番、条文の番号、社員番号のように、文字列がそのまま一致すればよいものは、昔ながらのキーワード検索のほうが正確です。問い合わせの8割が同じ20問なら、FAQ ページを整えるほうが安く早いこともあります。
判断の材料なら、ツールとして渡す
AI に業務の操作(在庫を引く、予約を入れる)までさせたいなら、資料を渡すのではなく、操作をツールとして AI に渡す方法があります。これは RAG とは別の話で、MCP のような仕組みの領域です。
それでも RAG が向いている場面
- 資料が数千ページ以上あり、全部は渡せない
- 資料が頻繁に増え、追加のたびに作り直したくない
- 質問の多くが「どこかに書いてあることを探す」型
- 部署ごとに見てよい資料が違い、検索の段階で絞り込みたい
この場合も、区切り方の工夫、キーワード検索との併用、選んだ断片を並べ直す処理(リランキング)などで精度は上がります。先の Anthropic の記事では、断片に文書全体の文脈を書き足してから埋め込む方法とキーワード検索を併用して検索の失敗を49%、リランキングも加えて67%減らせたと報告しています。つまり、精度を上げる工夫の多くは「AI」ではなく「検索」の側の工夫です。
まとめ:方式を選ぶ5つの問い
社内データを AI に答えさせる前に、次の5つを上から順に確かめると、方式が自然に決まります。
| 確かめること | こうなら | 選ぶ方法 |
|---|---|---|
| 答えは文書にあるか、業務システムのデータにあるか | 件数・金額・一覧など、データにある | データベースや API に問い合わせる |
| 文書の量は、全部渡せる範囲か | 数百ページ以内 | まず全部渡して試す |
| 質問は「1か所を探す」型か、「数える・比べる」型か | 全体を数える・比べる・要約する | 全部渡すか、集計を別に用意する |
| 番号や型番での検索が多いか | 多い | キーワード検索を併用する |
| 答えの根拠を人が確かめる運用になっているか | なっていない | 根拠の断片を答えと一緒に出す |
どれにも当てはまらず、資料が大量にあって「どこかに書いてあることを探す」質問が中心なら、そこで初めて RAG の出番です。
RAG は便利な道具ですが、道具の1つにすぎません。中身が「区切って、ベクトルにして、近いものを選ぶ」だと分かっていれば、自社のデータと質問に合う方法を選べます。
Vitalify Asia では、生成 AI を業務システムやサービスに組み込む開発に取り組んでいます。この記事で紹介したような、社内データを AI に答えさせる方式の改発も経験してきました。社内の資料やデータを AI で活用したいとお考えなら、こちらからお気軽にご相談ください。
VFAはこれまで2008年から1000件以上の開発に携わってきました。非公開の開発実績もございますので、詳しくはお気軽にご相談ください。
各サービスの仕様は継続的に更新されています。本記事の内容は2026年11月20日時点のものです。
Vitalify Asia Co., Ltd. https://vitalify.asia/
1,000社以上の事業成長を支えた圧倒的な『スピードと柔軟性』で、御社のアイデアを最短で形にします。まずは無料で壁打ちしませんか?