RAG chỉ là chia nhỏ, vector hóa và chọn đoạn gần nhất. Vì vậy không phải việc gì cũng cần RAG
Muốn AI trả lời từ tài liệu nội bộ, người ta thường nghĩ ngay đến RAG. Bản chất là chia nhỏ tài liệu, vector hóa rồi đưa các đoạn gần câu hỏi nhất cho AI. Hiểu điều này, bạn sẽ biết RAG mạnh, yếu ở đâu và khi nào không cần dùng.
Nội dung bài viết
- Điểm chính của bài viết
- RAG làm gì: 4 bước
- 1. Chia nhỏ (chunking)
- 2. Vector hóa (embedding)
- 3. Chọn đoạn gần nhất (truy xuất)
- 4. Đưa vào và trả lời (sinh văn bản)
- Từ cơ chế suy ra: RAG yếu ở đâu
- Khi nào không nên dùng RAG, và dùng gì thay thế
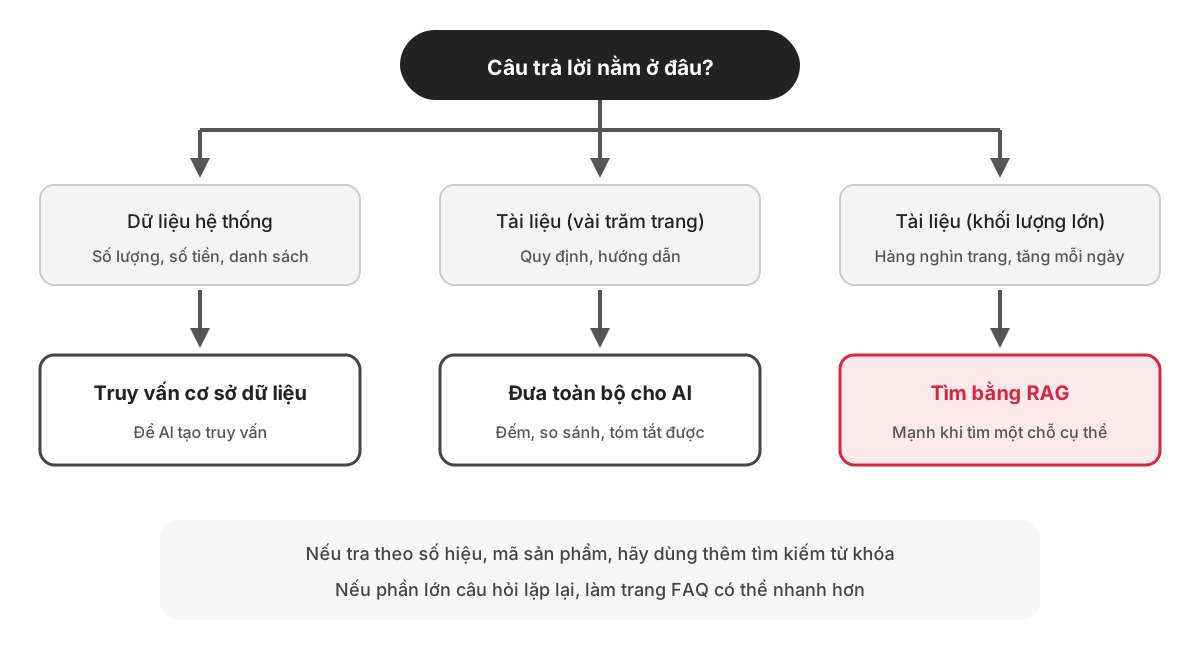
- Tài liệu ít thì đưa toàn bộ
- Số liệu và danh sách thì hỏi cơ sở dữ liệu
- Câu hỏi theo khuôn mẫu thì tìm kiếm thông thường hoặc FAQ là đủ
- Muốn AI thao tác thì đưa cho AI công cụ
- Khi nào RAG vẫn là lựa chọn phù hợp
- Tóm tắt: 5 câu hỏi để chọn phương pháp
Bạn muốn AI đọc tài liệu nội bộ và trả lời câu hỏi. Khi đem chuyện này đi hỏi, câu trả lời gần như luôn là "Vậy thì dùng RAG đi". Có lẽ bạn cũng từng gặp?
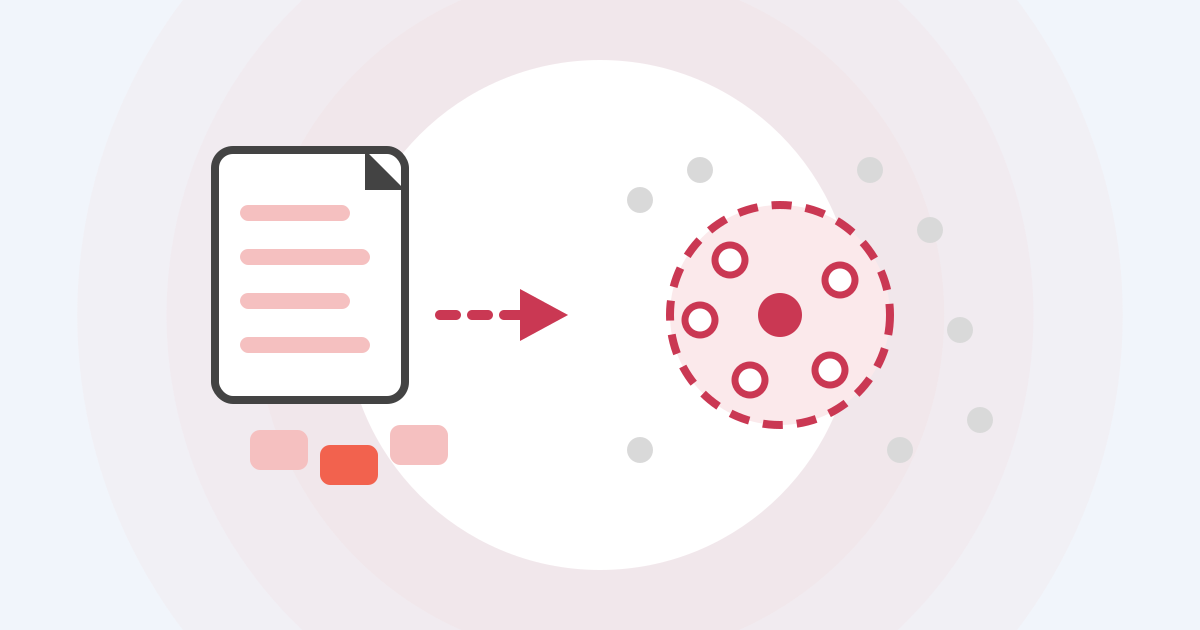
RAG (Retrieval-Augmented Generation, sinh văn bản có tăng cường truy xuất) nghe thì phức tạp, nhưng cách làm lại khá đơn giản. Chia tài liệu thành các đoạn nhỏ, biến mỗi đoạn thành một dãy số (vector), chọn vài đoạn gần với câu hỏi nhất rồi đưa cho AI. Chỉ có vậy.
Chính vì đơn giản nên điểm mạnh và điểm yếu của nó rất rõ ràng. Bài viết này dùng một bộ quy định nội bộ giả định để lần lượt giải thích cách RAG hoạt động, rồi tổng hợp những trường hợp RAG không phù hợp và cách thay thế.
Điểm chính của bài viết
- RAG không phải công nghệ làm AI thông minh hơn, mà là cơ chế tìm kiếm để chọn tài liệu đưa cho AI. Chất lượng câu trả lời phụ thuộc vào chất lượng các đoạn được chọn.
- Vì chỉ chọn "các đoạn gần nhất", RAG yếu với câu hỏi cần đếm số lượng, so sánh toàn bộ hay lấy số liệu mới nhất.
- Nếu tài liệu ít, cứ đưa toàn bộ cho AI. Nếu cần số liệu, hãy truy vấn cơ sở dữ liệu. RAG chỉ là một trong các lựa chọn.
RAG làm gì: 4 bước
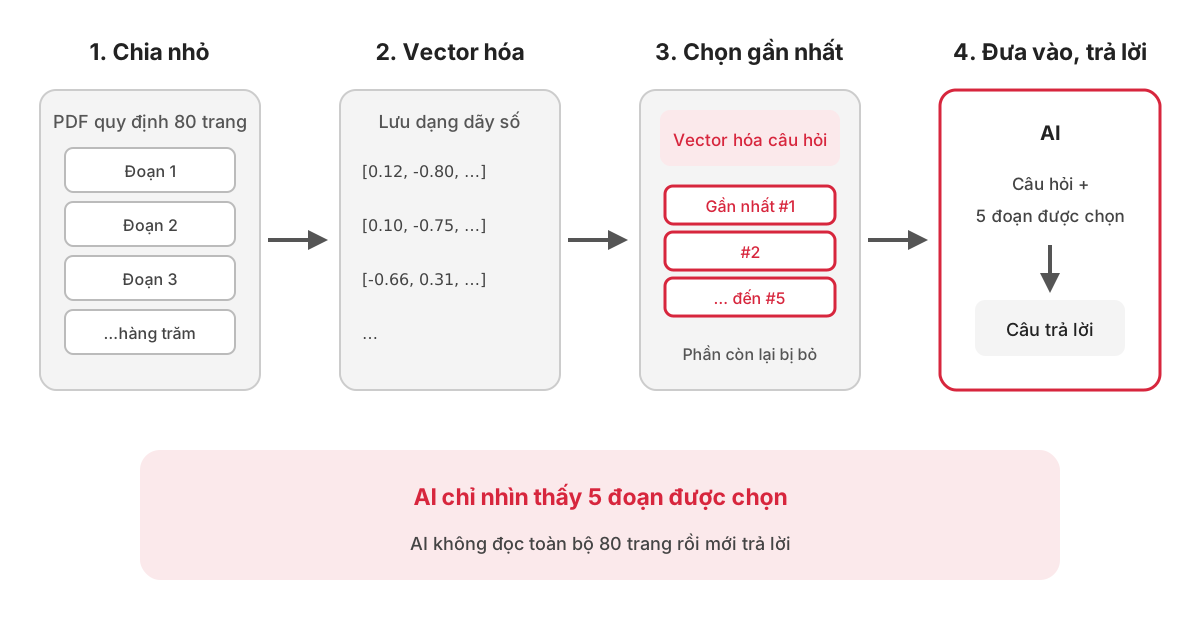
Lấy ví dụ một công ty 300 nhân viên muốn AI trả lời về nội quy lao động, quy định chi phí và quy định công tác (tổng cộng 80 trang PDF).
1. Chia nhỏ (chunking)
Đầu tiên, tài liệu được cắt thành các đoạn (chunk) dài khoảng vài trăm ký tự. 80 trang sẽ thành vài trăm đoạn.
Không có cách chia nào là đúng tuyệt đối. Có thể cắt máy móc theo số ký tự, cắt theo tiêu đề, hoặc cắt chồng lên nhau một chút, và lựa chọn này ảnh hưởng lớn đến chất lượng câu trả lời. Nếu tiêu đề "Điều 12: Công tác phí" và dòng bên dưới "trừ ban giám đốc" nằm ở hai đoạn khác nhau, bước sau có thể chỉ chọn được một trong hai.
2. Vector hóa (embedding)
Tiếp theo, mỗi đoạn được tạo một dãy số gọi là embedding. Đưa văn bản vào mô hình embedding sẽ nhận lại từ vài trăm đến vài nghìn con số. Mô hình được xây dựng sao cho các câu có nghĩa gần nhau thì dãy số cũng gần nhau.
Ví dụ, "Phụ cấp công tác mỗi ngày là bao nhiêu?" và "Phụ cấp công tác trong nước là 2.000 yên một ngày" dùng từ khác nhau nhưng cho ra dãy số gần nhau. Đây là điểm khác với tìm kiếm toàn văn truyền thống, vốn không tìm thấy gì nếu từ khóa không khớp.
Các dãy số này được lưu vào cơ sở dữ liệu vector cùng với nội dung của từng đoạn.
3. Chọn đoạn gần nhất (truy xuất)
Khi người dùng đặt câu hỏi, câu hỏi cũng được biến thành dãy số bằng cùng mô hình. Sau đó, trong vài trăm đoạn đã lưu, hệ thống chọn ra vài đoạn (ví dụ 5 đoạn) có dãy số gần với câu hỏi nhất.
Độ gần được đo bằng mức độ hai dãy số "cùng hướng" với nhau.
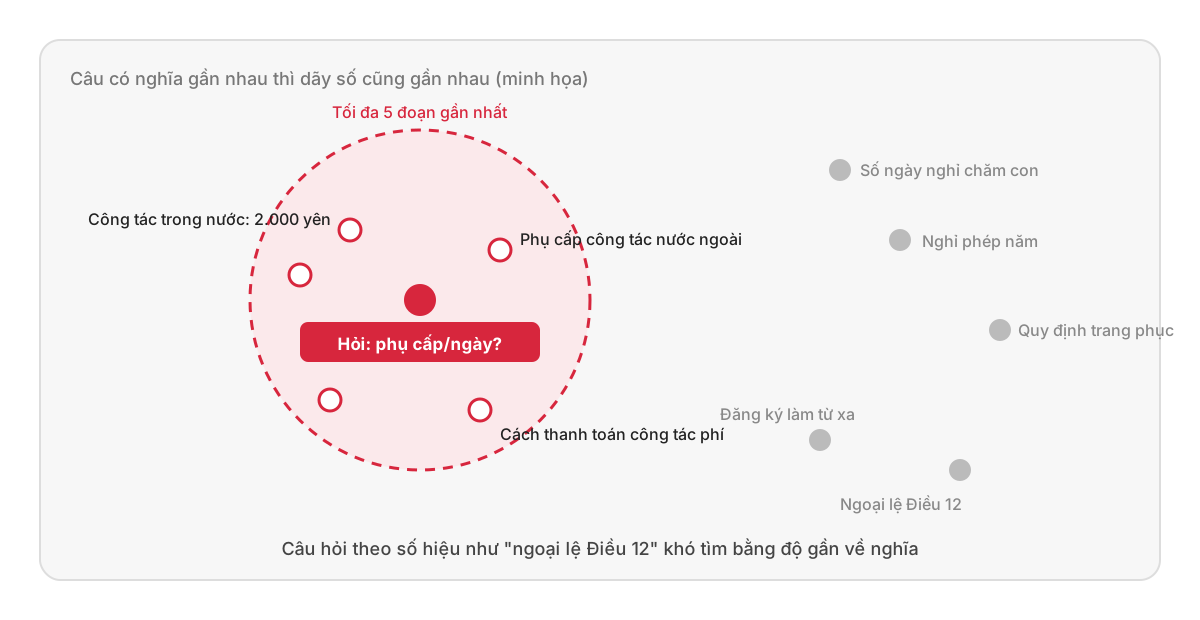
Hệ thống không chọn vì hiểu nghĩa, mà chọn một cách máy móc theo độ gần của các con số.
4. Đưa vào và trả lời (sinh văn bản)
Cuối cùng, 5 đoạn được chọn và câu hỏi được đưa cùng lúc cho AI kèm yêu cầu "Hãy trả lời dựa trên tài liệu này". AI chỉ nhìn thấy 5 đoạn này. AI không hề đọc toàn bộ 80 trang quy định.
Từ cơ chế suy ra: RAG yếu ở đâu
AI chỉ nhìn thấy "vài đoạn gần với câu hỏi". Chỉ từ điểm này, ta đã thấy được những loại câu hỏi RAG xử lý kém.
| Ví dụ câu hỏi | Vì sao khó |
|---|---|
| "Liệt kê tất cả thủ tục cần cấp trên phê duyệt trong các quy định" | Dù chỗ liên quan nằm rải rác hàng chục nơi, chỉ vài đoạn đầu được đưa vào |
| "Vì sao mức trần tiền khách sạn trong quy định chi phí và quy định công tác lại khác nhau?" | Muốn so sánh hai tài liệu thì phải chọn được đoạn liên quan ở cả hai |
| "Tháng trước có bao nhiêu hồ sơ thanh toán chi phí?" | Số lượng và tổng nằm trong dữ liệu hệ thống nghiệp vụ, không nằm trong tài liệu |
| "Tóm lại quy định này muốn nói gì?" | Tóm tắt cần toàn bộ, nhưng chỉ một phần được đưa vào |
| "Ngoại lệ của Điều 12 là gì?" | Số hiệu như "Điều 12" hay mã sản phẩm khó tìm bằng độ gần về nghĩa |
Ngược lại, RAG mạnh với câu hỏi mà câu trả lời nằm ở một hai chỗ trong tài liệu. Các câu hỏi FAQ nội bộ như "Phụ cấp công tác mỗi ngày là bao nhiêu?" hay "Được nghỉ chăm con bao nhiêu ngày?" thuộc loại này.
Còn một hiểu lầm phổ biến nữa. RAG không phải công nghệ giúp AI "hết bịa". Nếu chọn nhầm đoạn không liên quan, AI vẫn sẽ dựa vào đó để tạo ra câu trả lời nghe rất hợp lý. Vì vậy, thông thường hệ thống sẽ hiển thị "câu trả lời dựa trên đoạn nào" để con người kiểm tra.
Khi nào không nên dùng RAG, và dùng gì thay thế
Tài liệu ít thì đưa toàn bộ
AI ngày nay có thể đọc một lượng văn bản khá lớn trong một lần. Trong bài viết giới thiệu một kỹ thuật cải tiến RAG, Anthropic viết:
If your knowledge base is smaller than 200,000 tokens (about 500 pages of material), you can just include the entire knowledge base in the prompt that you give the model, with no need for RAG or similar methods.
(Dịch) Nếu kho kiến thức nhỏ hơn 200.000 token (khoảng 500 trang tài liệu), bạn chỉ cần đưa toàn bộ kho kiến thức vào prompt cho mô hình, không cần RAG hay các phương pháp tương tự.
— Anthropic, "Introducing Contextual Retrieval" (tháng 9/2024)
80 trang quy định trong ví dụ có thể đưa nguyên vẹn mà không cần chia nhỏ. Vì AI đọc toàn bộ nên có thể trả lời cả "liệt kê hết", "so sánh" và "tóm tắt". Chi phí gửi lặp lại cùng một tài liệu có thể giảm bằng tính năng cache prompt.
Số liệu và danh sách thì hỏi cơ sở dữ liệu
Câu trả lời cho "Tháng trước có bao nhiêu hồ sơ thanh toán chi phí?" nằm trong cơ sở dữ liệu của hệ thống thanh toán, không nằm trong tài liệu. Khi đó, để AI tạo câu lệnh SQL hoặc lời gọi API và truy vấn trực tiếp cơ sở dữ liệu sẽ chắc chắn hơn. Nếu dùng RAG tìm trong các báo cáo tháng, có nguy cơ lấy nhầm số liệu của tháng cũ.
Câu hỏi theo khuôn mẫu thì tìm kiếm thông thường hoặc FAQ là đủ
Với những thứ chỉ cần khớp chuỗi ký tự, như mã sản phẩm, số điều khoản hay mã nhân viên, tìm kiếm từ khóa truyền thống chính xác hơn. Nếu 80% câu hỏi là cùng 20 câu, chỉnh trang FAQ có thể rẻ và nhanh hơn.
Muốn AI thao tác thì đưa cho AI công cụ
Nếu muốn AI thực hiện cả thao tác nghiệp vụ (trừ tồn kho, đặt chỗ), thay vì đưa tài liệu, có thể đưa các thao tác đó cho AI dưới dạng công cụ. Đây là chủ đề khác với RAG, thuộc về các cơ chế như MCP.
Khi nào RAG vẫn là lựa chọn phù hợp
- Tài liệu có hàng nghìn trang trở lên, không thể đưa toàn bộ
- Tài liệu tăng thường xuyên, không muốn xây lại mỗi lần thêm
- Phần lớn câu hỏi thuộc loại "tìm điều được viết ở đâu đó"
- Mỗi phòng ban được xem tài liệu khác nhau, muốn lọc ngay ở bước tìm kiếm
Ngay cả khi đó, độ chính xác vẫn tăng nhờ cải tiến cách chia, kết hợp tìm kiếm từ khóa và sắp xếp lại các đoạn đã chọn (reranking). Trong bài viết nói trên của Anthropic, việc bổ sung ngữ cảnh của toàn tài liệu vào từng đoạn trước khi embedding, kết hợp với tìm kiếm từ khóa, đã giảm 49% lỗi truy xuất, và thêm reranking thì giảm 67%. Nói cách khác, phần lớn cải tiến nằm ở phía "tìm kiếm", không phải ở phía "AI".
Tóm tắt: 5 câu hỏi để chọn phương pháp
Trước khi cho AI trả lời dựa trên dữ liệu công ty, hãy kiểm tra 5 điểm sau theo thứ tự từ trên xuống, phương pháp phù hợp sẽ tự nhiên hiện ra.
| Điều cần kiểm tra | Nếu | Chọn |
|---|---|---|
| Câu trả lời nằm trong tài liệu hay trong dữ liệu hệ thống? | Nằm trong dữ liệu: số lượng, số tiền, danh sách | Truy vấn cơ sở dữ liệu hoặc API |
| Lượng tài liệu có đưa toàn bộ được không? | Vài trăm trang trở xuống | Thử đưa toàn bộ trước |
| Câu hỏi là "tìm một chỗ" hay "đếm, so sánh"? | Đếm, so sánh, tóm tắt toàn bộ | Đưa toàn bộ, hoặc chuẩn bị số liệu tổng hợp riêng |
| Có nhiều tìm kiếm theo số hiệu, mã sản phẩm không? | Nhiều | Dùng thêm tìm kiếm từ khóa |
| Con người có kiểm tra được căn cứ của câu trả lời không? | Không | Hiển thị đoạn căn cứ kèm câu trả lời |
Nếu không rơi vào trường hợp nào ở trên, và bạn có lượng tài liệu lớn với câu hỏi chủ yếu là "tìm điều được viết ở đâu đó", lúc đó mới đến lượt RAG.
RAG là công cụ hữu ích, nhưng chỉ là một trong nhiều công cụ. Khi đã hiểu bản chất là "chia nhỏ, vector hóa, chọn đoạn gần nhất", bạn có thể chọn phương pháp phù hợp với dữ liệu và câu hỏi của doanh nghiệp mình.
Vitalify Asia đang phát triển các giải pháp tích hợp AI tạo sinh vào hệ thống nghiệp vụ và dịch vụ. Chúng tôi cũng đã có kinh nghiệm phát triển các phương pháp để AI trả lời dựa trên dữ liệu nội bộ như trong bài viết này. Nếu bạn đang muốn tận dụng tài liệu và dữ liệu nội bộ với AI, hãy liên hệ với chúng tôi.
Từ năm 2008 đến nay, VFA đã tham gia hơn 1.000 dự án phát triển. Nhiều dự án không được công bố, vui lòng liên hệ để biết thêm chi tiết.
Danh sách dự án phát triển của Vitalify Asia
Thông số của các dịch vụ được cập nhật liên tục. Nội dung bài viết này dựa trên thông tin tại thời điểm ngày 20/11/2026.
Vitalify Asia Co., Ltd. https://vitalify.asia/
Đừng để ý tưởng chỉ nằm trên giấy. Với tốc độ và sự linh hoạt đã được chứng minh qua 1.000+ dự án, chúng tôi sẽ giúp doanh nghiệp của bạn bứt phá.