Nâng cấp Gemini TTS từ 3.1 lên 3.8: Những điểm cần lưu ý
Gemini TTS 3.8 thay đổi cách xử lý chỉ dẫn style, định dạng âm thanh và lựa chọn giọng. Bài viết chia sẻ các lỗi chúng tôi gặp khi nâng cấp từ 3.1, như AI đọc cả phần chỉ dẫn hoặc phát sinh tạp âm do WAV header, cùng quy trình thực tế để tạo nội dung TTS ổn định hơn.
Nội dung bài viết
Khi nâng cấp mô hình chuyển văn bản thành giọng nói (TTS) của Gemini từ dòng 3.1 lên dòng 3.8, mô hình bắt đầu đọc to cả phần chỉ dẫn về cách nói. Âm thanh dài hơn trước rất nhiều, và có đoạn còn lặp lại cùng một câu.
Bài viết này giới thiệu sự khác biệt mà chúng tôi gặp phải khi phát triển nội dung âm thanh, cùng với nguyên nhân của nó. Chúng tôi cũng giới thiệu cách chọn giọng khi số lượng giọng ở 3.8 đã tăng lên rất nhiều, và quy trình tạo nội dung âm thanh bằng TTS theo từng giai đoạn.
Nội dung dựa trên tài liệu chính thức của Gemini API tại thời điểm ngày 16/11/2026 và kết quả chúng tôi đã kiểm chứng trong quá trình phát triển.
Vị trí đặt chỉ dẫn: 3.1 và 3.8
Với TTS dòng 3.1 (gemini-3.1-flash-tts-preview), chúng tôi gửi chỉ dẫn về cách nói và lời thoại gộp chung trong một đoạn văn bản. Ví dụ như sau:
[Chỉ dẫn]
Hãy nói với giọng điềm tĩnh, chậm rãi và cẩn thận.
Ngắt nghỉ một chút giữa các câu.

[Lời thoại]
Đây là một bức trong loạt tranh hoa súng mà họa sĩ vẽ vào những năm cuối đời.
Với 3.1, mô hình làm theo chỉ dẫn và chỉ đọc phần lời thoại. Nhưng khi gửi cùng định dạng này cho dòng 3.8 (gemini-3.8-flash-tts / gemini-3.8-flash-lite-tts), mô hình đọc to cả phần [Chỉ dẫn].
Tài liệu chính thức ghi rằng 3.8 coi văn bản là đúng nguyên văn lời cần đọc.
Gemini 3.8 TTS treats the text field strictly as a verbatim transcript.
(Gemini 3.8 TTS coi trường text là bản lời thoại nguyên văn từng chữ)
— Text-to-speech generation (TTS)
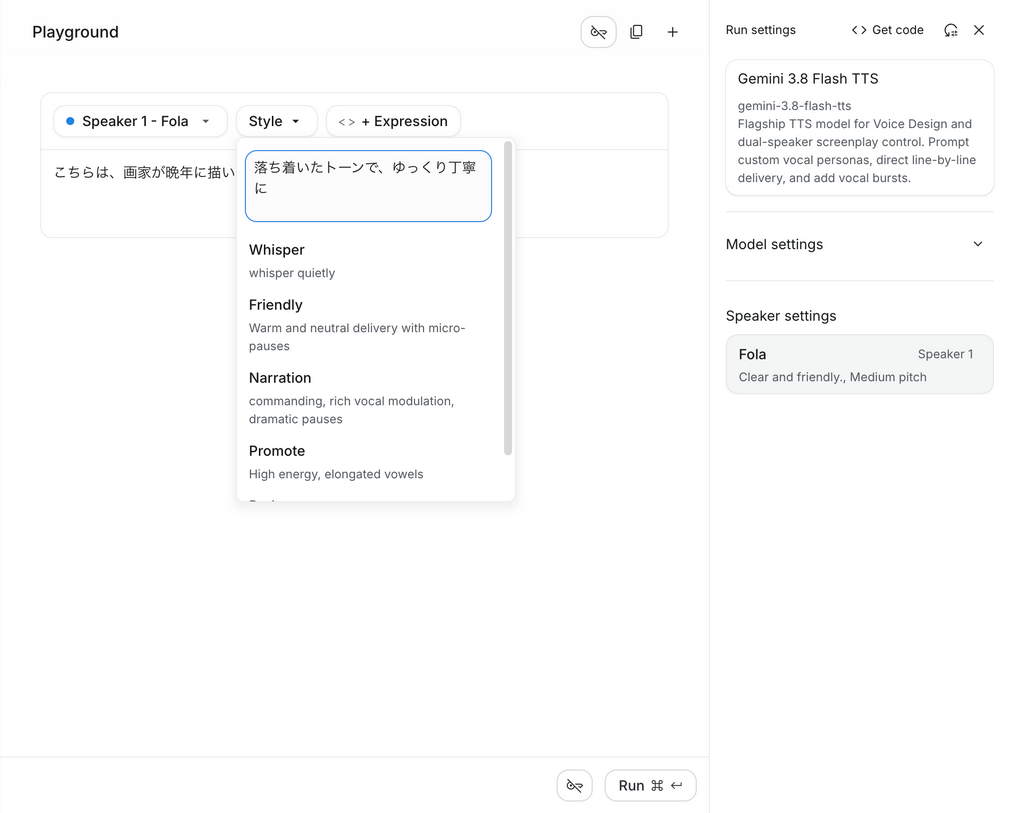
Ở 3.8, chỉ dẫn về cách nói được đặt vào trường style của speech_metadata. Phần văn bản chỉ chứa lời thoại.
{
  "parts": [{
    "text": "Đây là một bức trong loạt tranh hoa súng mà họa sĩ vẽ vào những năm cuối đời.",
    "speech_metadata": { "style": "giọng điềm tĩnh, chậm rãi và cẩn thận" }
  }]
}
Trên màn hình Google AI Studio, ô nhập lời thoại và ô "Style" cũng được tách riêng.
Hướng dẫn chuyển đổi chính thức nêu 5 điểm cần xem lại khi nâng cấp từ 3.1 lên 3.8.
| Thay đổi | Nội dung |
|---|---|
| Tách chỉ dẫn khỏi lời thoại | Chuyển chỉ dẫn về cách nói sang speech_metadata.style, phần văn bản chỉ gồm lời thoại và thẻ phát âm |
| Tạo nhân vật bằng Voice design | Thay đoạn mô tả nhân vật dài bằng ID giọng tạo từ Voice design |
| Gửi hội thoại theo từng lượt | Không viết "Người nói: lời thoại" trong một văn bản mà gửi riêng theo từng người nói |
| Viết thẻ phát âm trong dấu ngoặc nhọn | Dùng <laugh>, <sigh>, <short pause>… và không dùng thẻ hiệu ứng âm thanh |
| Định dạng âm thanh trả về thay đổi | 3.1 trả về PCM không có header, 3.8 trả về WAV có header |
Chúng tôi gặp phải cả điểm thứ nhất và điểm thứ năm.
Định dạng âm thanh trả về
Ở 3.8, định dạng âm thanh trả về cũng thay đổi. Thay đổi thứ năm là nguyên nhân gây ra tạp âm.
3.1 trả về dữ liệu âm thanh thô (PCM) không có header. 3.8 trả về tệp WAV có header ở đầu.
Nếu vẫn coi toàn bộ dữ liệu trả về là âm thanh như thời 3.1, phần header cũng bị phát ra thành tiếng. Trong trường hợp của chúng tôi, đầu mỗi đoạn có tiếng "tách" và cuối đoạn có tạp âm.
Có hai cách xử lý. Chỉ lấy phần dữ liệu âm thanh (data chunk) từ tệp WAV, hoặc chỉ định định dạng trả về là audio/l16 (PCM không có header) trong yêu cầu. Phần Limitations của tài liệu chính thức cũng ghi rằng khi nối các đoạn âm thanh tạo theo từng câu thoại, cần bỏ header trước khi nối.
Sau khi sửa lại cho phù hợp với 3.8, cả hiện tượng đọc to chỉ dẫn lẫn tạp âm đều không còn xảy ra.
Cách chọn giọng
Thay đổi ở 3.8 không chỉ là vị trí đặt chỉ dẫn. Số giọng có thể chọn cũng tăng lên rất nhiều.
Với 3.1, về cơ bản bạn chọn trong 30 giọng. Với 3.8, ngoài 30 giọng này còn có hàng trăm giọng trong Extended Voice Library. Ô tìm kiếm trên AI Studio hiển thị "Search 2,000+ voices".
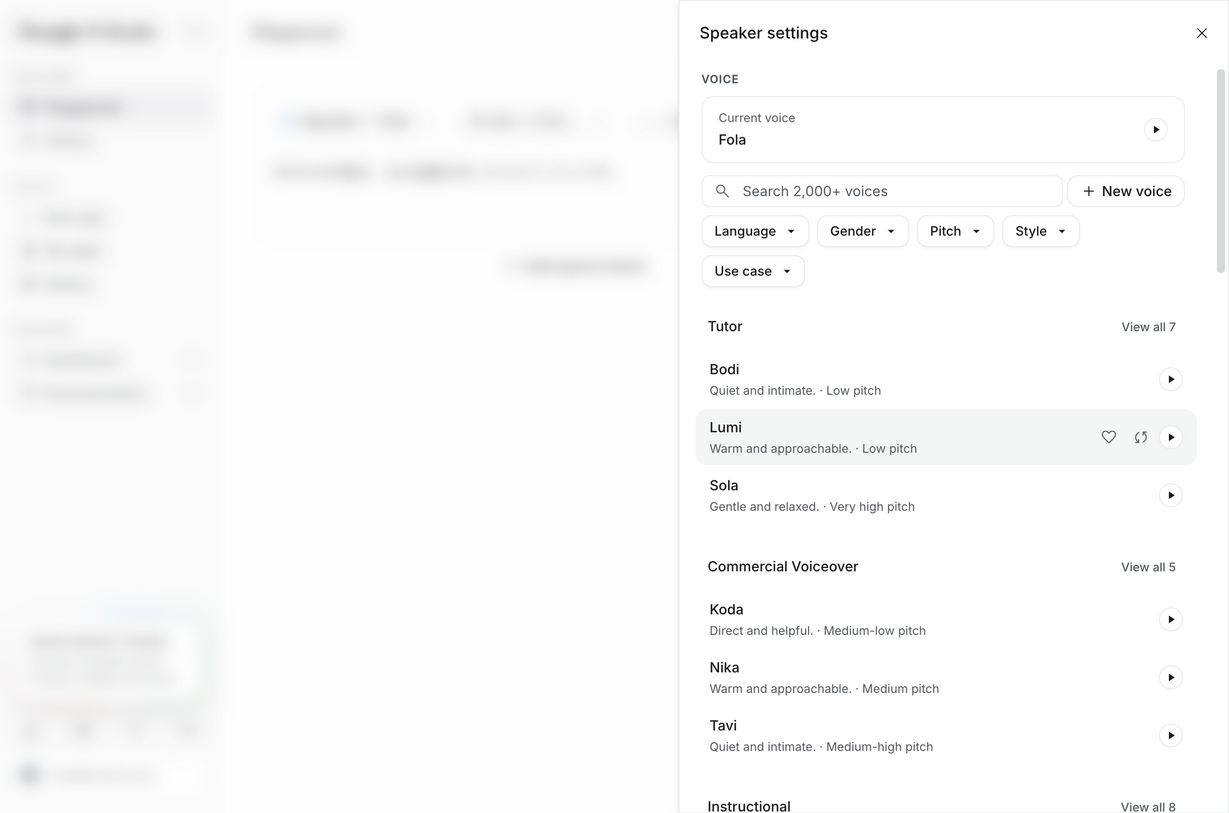
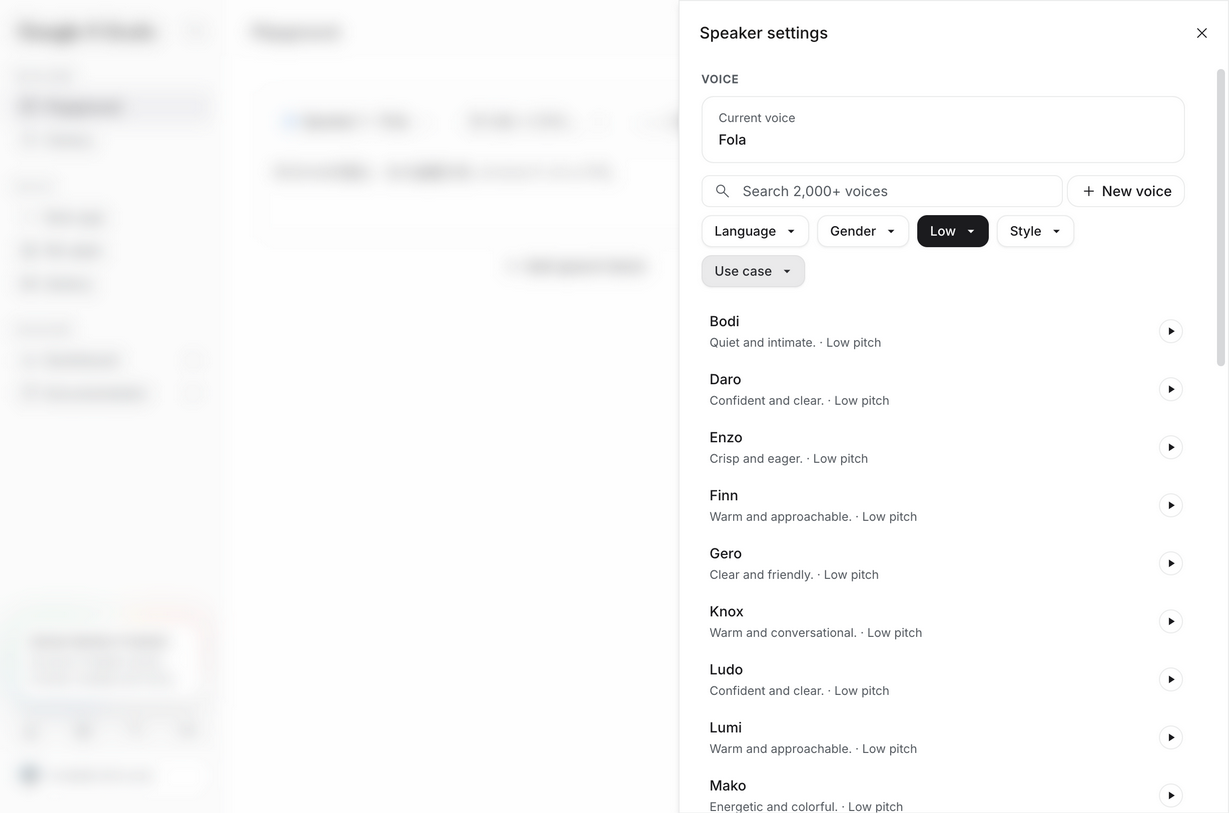
Với số lượng lớn như vậy, nghe thử từng giọng một là không thực tế. Speaker settings trên AI Studio cho phép lọc theo ngôn ngữ, giới tính, cao độ giọng (Pitch), cách nói (Style) và mục đích sử dụng (Use case).
Với nội dung cần giọng điềm tĩnh như thuyết minh tác phẩm nghệ thuật, chúng tôi khuyên nên kết hợp hai bộ lọc giới tính (Gender) và cao độ (Pitch). Chỉ cần đặt Pitch là Low, số ứng viên đã giảm đáng kể.
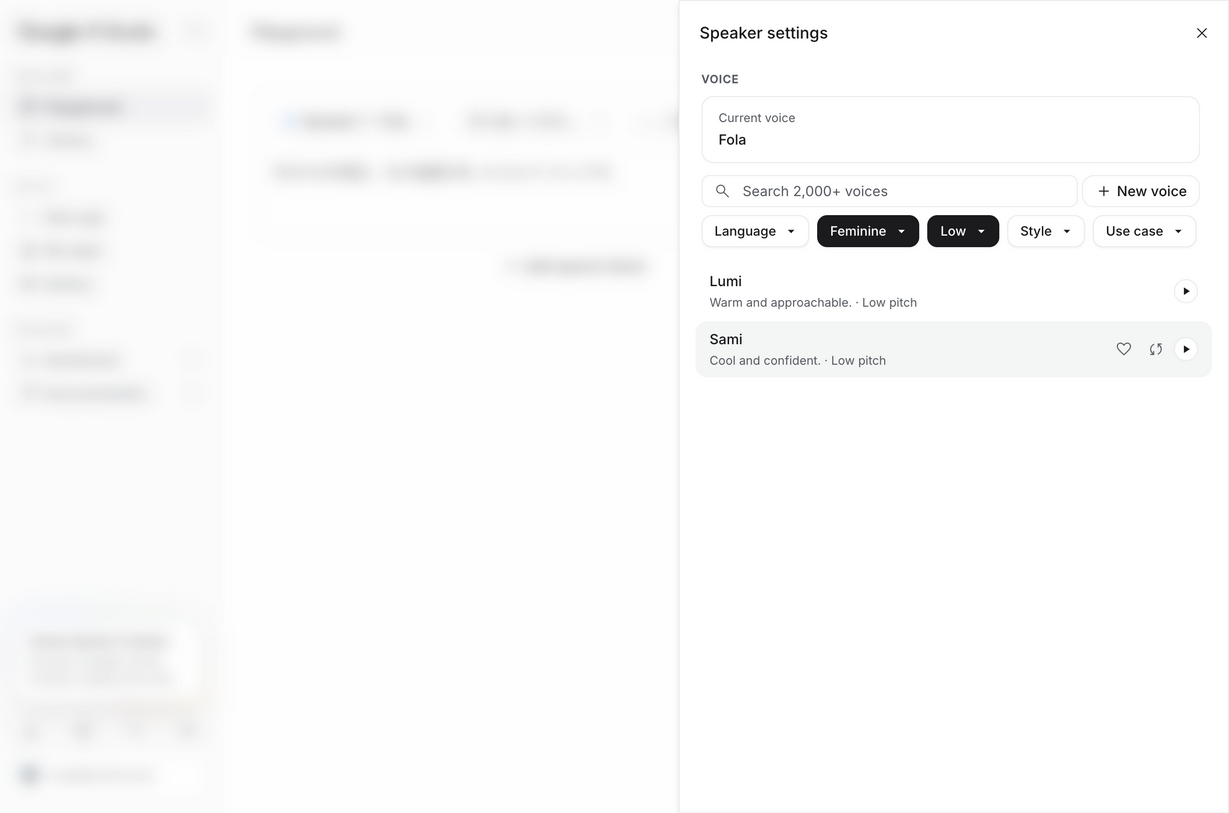
Thêm Gender = Feminine thì chỉ còn hai ứng viên. Khi đã ít như vậy, nghe thử tất cả chỉ mất vài phút. Các mô tả như "Warm and approachable" (ấm áp, gần gũi) hay "Cool and confident" (điềm tĩnh, tự tin) cũng là gợi ý hữu ích.
Khi làm thuyết minh tiếng Nhật, không lọc theo Language = Japanese sẽ dễ chọn hơn. Nếu lọc theo Japanese rồi thêm điều kiện giới tính hay cao độ, gần như không còn giọng nào. Với API key miễn phí, tổ hợp Japanese và Low cho kết quả 0 giọng. Những giọng không được đăng ký cho tiếng Nhật vẫn đọc tiếng Nhật khá tốt. Hãy để trống ngôn ngữ, lọc theo giới tính và cao độ, rồi cho các ứng viên đọc lời thoại thực tế để so sánh.
Có thể lọc tương tự bằng API. voices.list() (GET /v1beta/voices) nhận các điều kiện như language_code, gender, pitch, contexts. Cách làm nhanh là chọn sơ bộ trên AI Studio, rồi xác nhận ID giọng dùng cho môi trường thật bằng API.
Điều chỉnh không khí giọng nói bằng chỉ dẫn
Sau khi chọn giọng, bạn có thể tinh chỉnh bằng chỉ dẫn style. Ô Style trên AI Studio có sẵn các ví dụ như "Whisper", "Friendly", "Narration", "Podcast". Bạn cũng có thể viết tự do, ví dụ "giọng trầm, điềm tĩnh, chậm rãi và cẩn thận".
Tuy nhiên, Prompting guide chính thức khuyên không nên viết chỉ dẫn dài.
Long-form "Audio Profile" paragraphs and multi-bullet "Director's Notes" carried over from earlier models are the most common cause of voice drift.
(Những đoạn mô tả nhân vật dài và ghi chú đạo diễn nhiều gạch đầu dòng mang từ mô hình cũ sang là nguyên nhân phổ biến nhất khiến giọng bị lệch)
— Text-to-speech generation (TTS) / Prompting guide
Hướng dẫn khuyến nghị như sau.
- Trước tiên tạo với
styleđể trống. Phần lớn trường hợp không cần chỉ dẫn - Chỉ thêm chỉ dẫn ngắn cho những câu thoại cần điều chỉnh (ví dụ: "casual, friendly")
- Muốn giữ cùng một giọng điệu thì dùng lại cùng một chỉ dẫn ngắn cho mọi câu
- Không dùng
styleđể thay đổi đặc tính cố hữu như tuổi, giới tính, giọng địa phương. Hãy chọn giọng khác hoặc dùng Voice design - Không thêm lời nhắc kiểu "đừng đổi giọng". Càng nhiều chỉ dẫn, giọng càng dễ bị lệch
Nếu ở 3.1 bạn đã tinh chỉnh giọng bằng chỉ dẫn dài, khi lên 3.8 hãy rút ngắn chỉ dẫn và điều chỉnh bằng cách chọn lại giọng để kết quả ổn định hơn.
Tạo âm thanh theo từng giai đoạn
Cuối cùng, chúng tôi giới thiệu cách tạo nội dung âm thanh bằng TTS. Thay vì chuyển toàn bộ văn bản thành âm thanh một lần, chúng tôi chia thành các giai đoạn sau.
| Giai đoạn | Công việc | Công cụ |
|---|---|---|
| 1. Tạo kịch bản | Tạo thứ tự người nói và lời thoại từ tài liệu gốc (ghi chép phỏng vấn, Q&A…) | Mô hình tạo văn bản (Gemini 3.8 Flash), chỉ định đầu ra dạng JSON |
| 2. Hậu xử lý kịch bản | Thêm cách đọc cho các từ dễ đọc sai | Từ điển và xử lý thay thế |
| 3. Tạo âm thanh | Gửi từng câu thoại cho TTS để tạo âm thanh | Mô hình TTS (Gemini 3.8 Flash-Lite TTS) |
| 4. Ghép âm thanh | Điều chỉnh tốc độ, chèn khoảng lặng giữa các câu, cân âm lượng rồi ghép | Xử lý âm thanh |
Có hai lý do để chia giai đoạn.
Thứ nhất, chuyển một văn bản dài thành âm thanh trong một lần dễ làm giảm chất lượng. Khi tạo dài trong một lần, giọng có thể đổi điệu giữa chừng, hoặc bị đọc sót, đọc lặp. Nếu mỗi câu thoại là một yêu cầu, bạn chỉ cần tạo lại những câu có vấn đề. Hướng dẫn chính thức cũng khuyên chia câu trả lời dài thành các lượt ngắn thay vì dùng chỉ dẫn mạnh hơn.
Split long agent responses into shorter turns rather than reaching for stronger style prompts.
(Hãy chia câu trả lời dài thành các lượt ngắn hơn thay vì dựa vào chỉ dẫn style mạnh hơn)
— Text-to-speech generation (TTS) / Prompting guide
Thứ hai là dễ khoanh vùng nguyên nhân khi có vấn đề. Tùy lỗi nằm ở nội dung kịch bản, cách đọc hay chất lượng giọng mà giai đoạn cần sửa sẽ khác nhau. Nếu giữ lại tệp trung gian của từng giai đoạn (JSON kịch bản, âm thanh từng câu thoại), bạn có thể kiểm tra lại xem lỗi phát sinh ở đâu. Lần này, chúng tôi phát hiện hiện tượng đọc to chỉ dẫn bằng cách so sánh độ dài âm thanh của từng câu thoại.
Ngoài ra, nếu có tối đa hai người nói và dùng giọng có sẵn trên AI Studio, bạn cũng có thể tạo cả đoạn hội thoại trong một yêu cầu. Nếu kết hợp các giọng riêng tạo bằng Voice design…, cần tạo riêng theo từng người nói (xem phần Limitations của tài liệu chính thức).
Tổng kết
Khi nâng cấp Gemini TTS từ 3.1 lên 3.8, hãy kiểm tra các điểm sau.
・Chuyển chỉ dẫn về cách nói sang speech_metadata.style, phần văn bản chỉ chứa lời thoại
・Âm thanh trả về là WAV có header. Bỏ header trước khi ghép, hoặc chỉ định audio/l16
・Có hơn 2.000 giọng. Trên AI Studio, để trống ngôn ngữ, kết hợp lọc giới tính và Pitch rồi nghe so sánh
・Viết chỉ dẫn ngắn. Thử không có chỉ dẫn trước, chỉ thêm cho những câu cần thiết
・Tách giai đoạn tạo kịch bản và tạo âm thanh, tạo âm thanh theo từng câu thoại
Khi nâng phiên bản mô hình, kết quả có thể thay đổi dù yêu cầu giống hệt. Trước khi chuyển đổi, hãy đọc Migration guide chính thức và chuẩn bị cơ chế tự động kiểm tra độ dài âm thanh cũng như phần đầu và cuối mỗi đoạn để sớm phát hiện khác biệt.
Tại Vitalify Asia, chúng tôi phát triển nội dung âm thanh sử dụng tổng hợp giọng nói và các sản phẩm tích hợp AI tạo sinh. Chúng tôi đã có kinh nghiệm với việc chuyển đổi mô hình, tinh chỉnh giọng và kịch bản như trong bài viết này. Nếu bạn gặp khó khăn khi ứng dụng tổng hợp giọng nói hay AI tạo sinh, hãy liên hệ với chúng tôi tại đây.
Từ năm 2008 đến nay, VFA đã tham gia hơn 1.000 dự án phát triển. Chúng tôi còn nhiều dự án chưa công khai, vui lòng liên hệ để biết thêm chi tiết.
Danh sách dự án phát triển của Vitalify Asia
Thông số kỹ thuật của các dịch vụ được cập nhật liên tục. Nội dung bài viết được cập nhật tại thời điểm ngày 16/11/2026.
Vitalify Asia Co., Ltd. https://vitalify.asia/
Đừng để ý tưởng chỉ nằm trên giấy. Với tốc độ và sự linh hoạt đã được chứng minh qua 1.000+ dự án, chúng tôi sẽ giúp doanh nghiệp của bạn bứt phá.