PLATEAU × ODPTをCesiumで統合する:3D都市モデルと鉄道データ連携の実装知見
PLATEAUの3D都市モデルとODPTの鉄道データをCesium上で統合する過程では、座標系の違い、3D Tilesの最適化、不安定なスキーマ、路線推論、位置補間、APIセキュリティなど多くの課題が発生します。本記事では、実データと推論データを区別しながら、リアルタイム3D都市可視化を安定して構築するための実装知見とトレードオフを解説します。
目次
- 1. PLATEAU 3D Tiles: 3D都市は単にtilesetをロードするだけではない
- 2. なぜ建物が地面の上に「浮いて」いるのか?
- すべての場所に適用できる正確なオフセット値は存在しない
- 3. PLATEAUのアセットURLを直接保存してはいけない
- 解決策:datacatalogエンドポイントを使用する
- 4. テクスチャは美しいが、常に最適とは限らない
- なぜプロジェクトは lod2-notexture を選んだのか?
- 5. 橋梁(Bridge)は建物(Building)とは異なる
- 6. 未定義(undefined)のフィールドがレンダーループ全体をクラッシュさせることがある
- 解決策
- 7. PLATEAUは常に列挙型(enum)を返すわけではない
- トレードオフ
- 解決策
- 解決策:位置からの推論
- クライアントサイドでの補間(Interpolation)
- ODPTとOpenStreetMapの組み合わせ
- マルチソース・マルチターゲットDijkstra法
- 路線IDの固定(Pin railway ID)
- 解決策
- 列車のステータスが常に「Unknown」と表示される
- 駅に停車中の列車をクリックすると、常に駅が選択されてしまう
- 1. オープンデータが完璧なデータであるとは限らない
- 2. 「実データ」と「推論データ」を区別しなければならない
- 3. 形状とセマンティックデータは相互に補完し合える
- 4. 安定性が絶対的な正確さよりも重要な場合がある
- 5. パフォーマンスは単にFPSだけの問題ではない
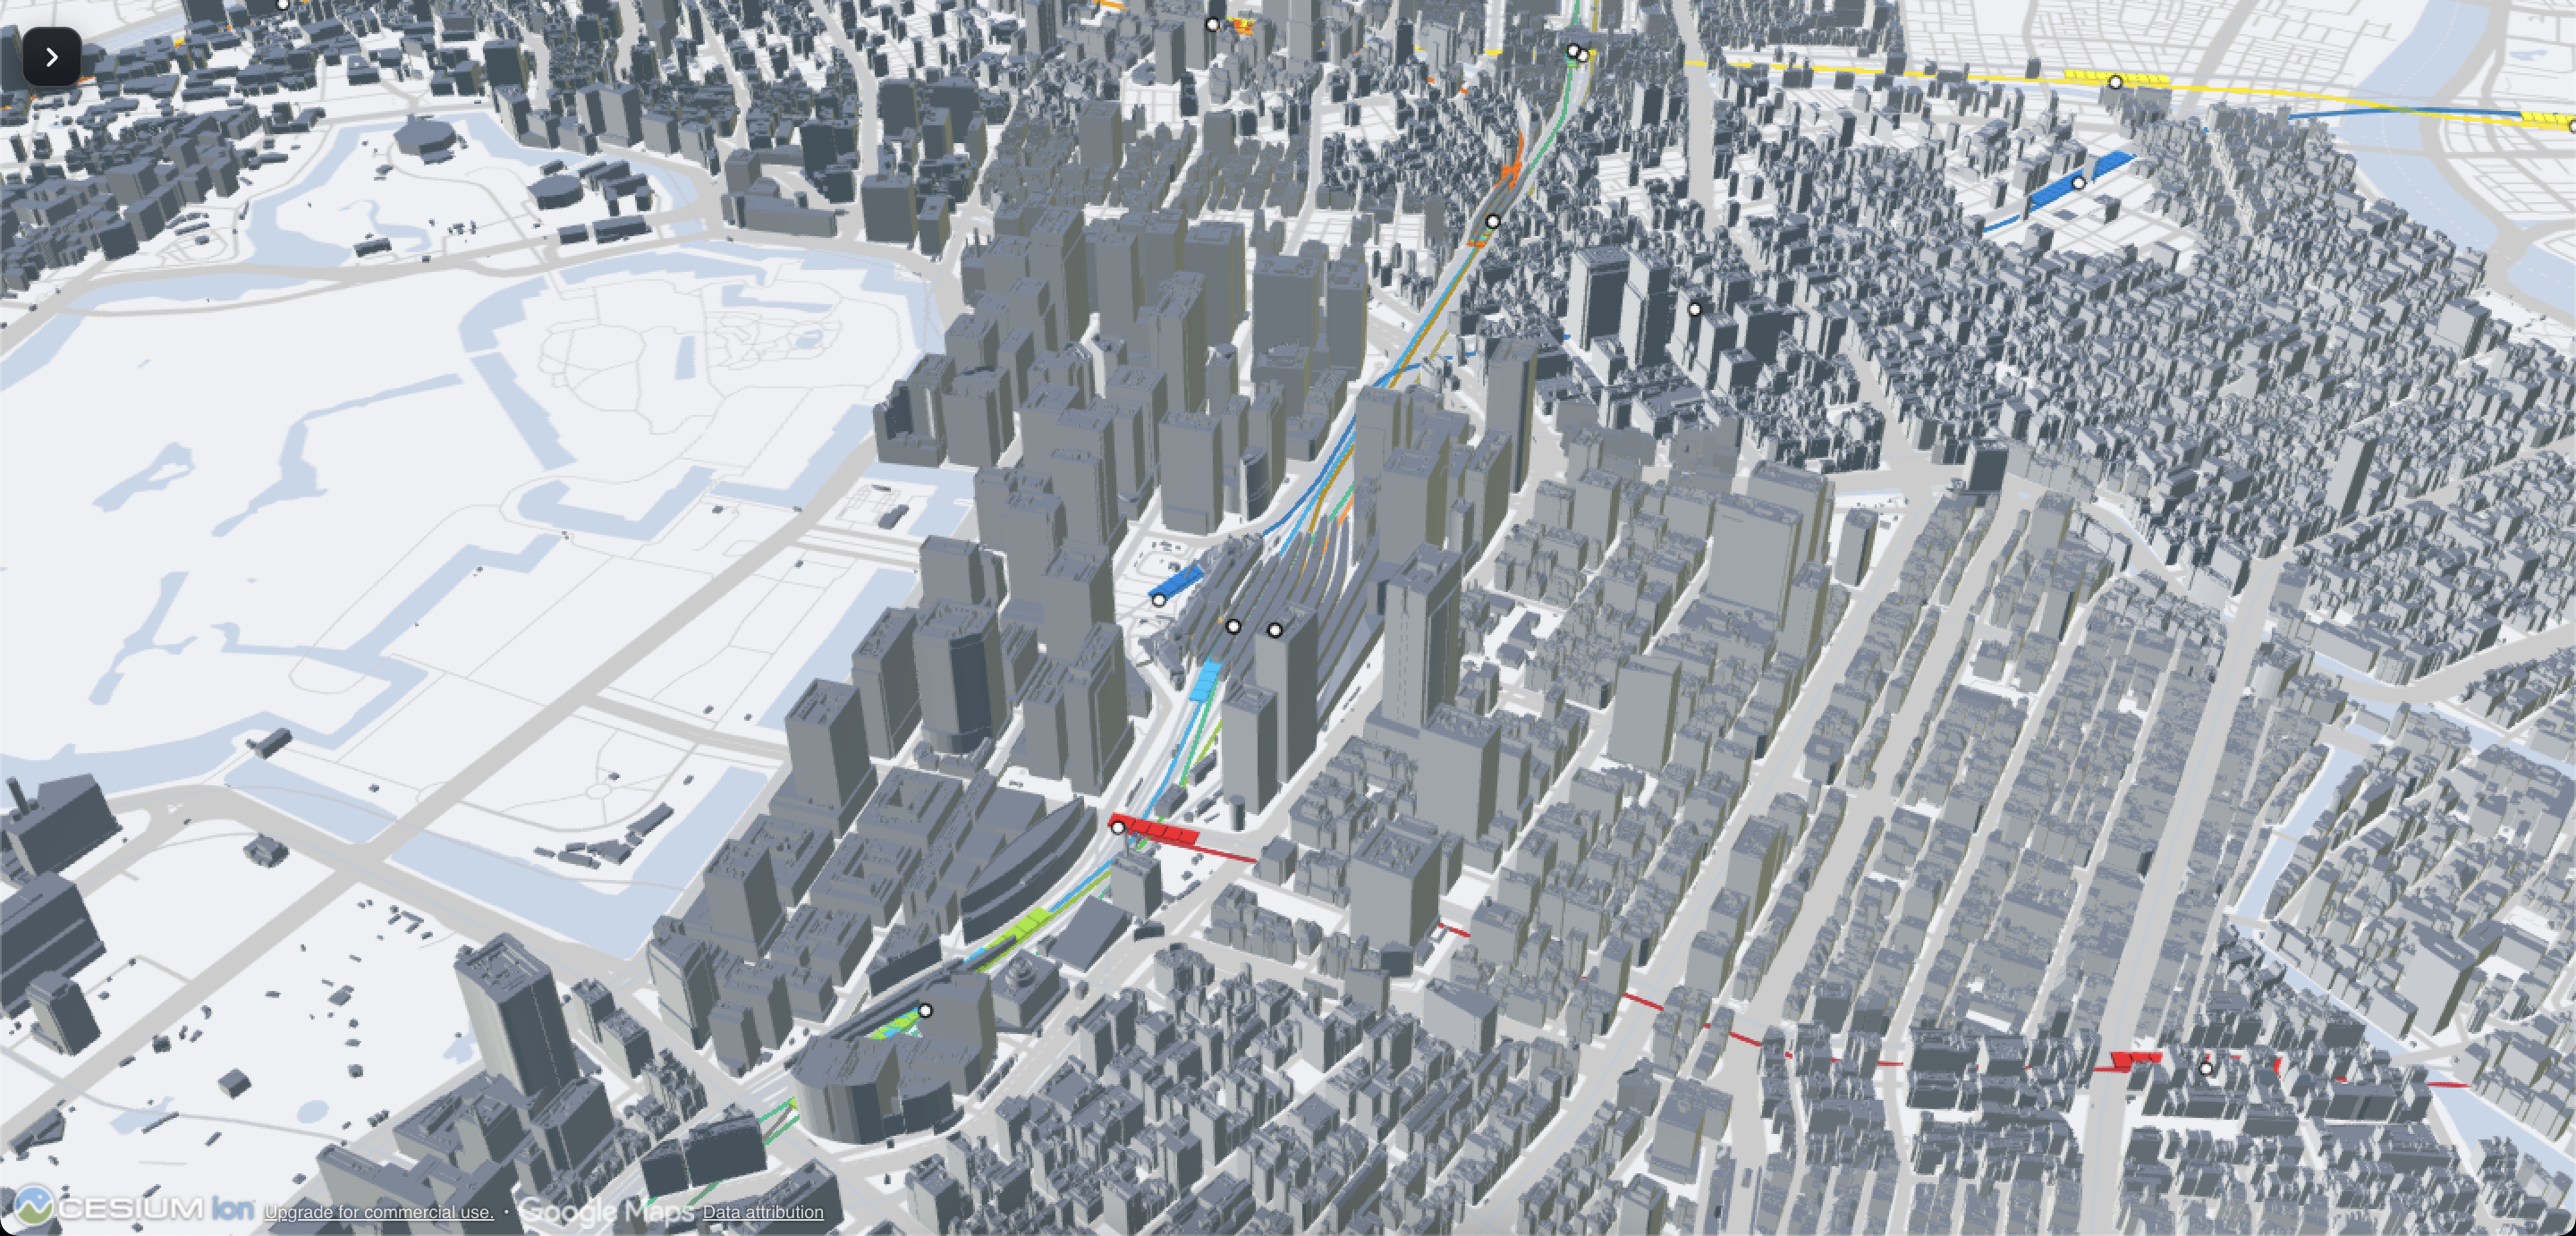
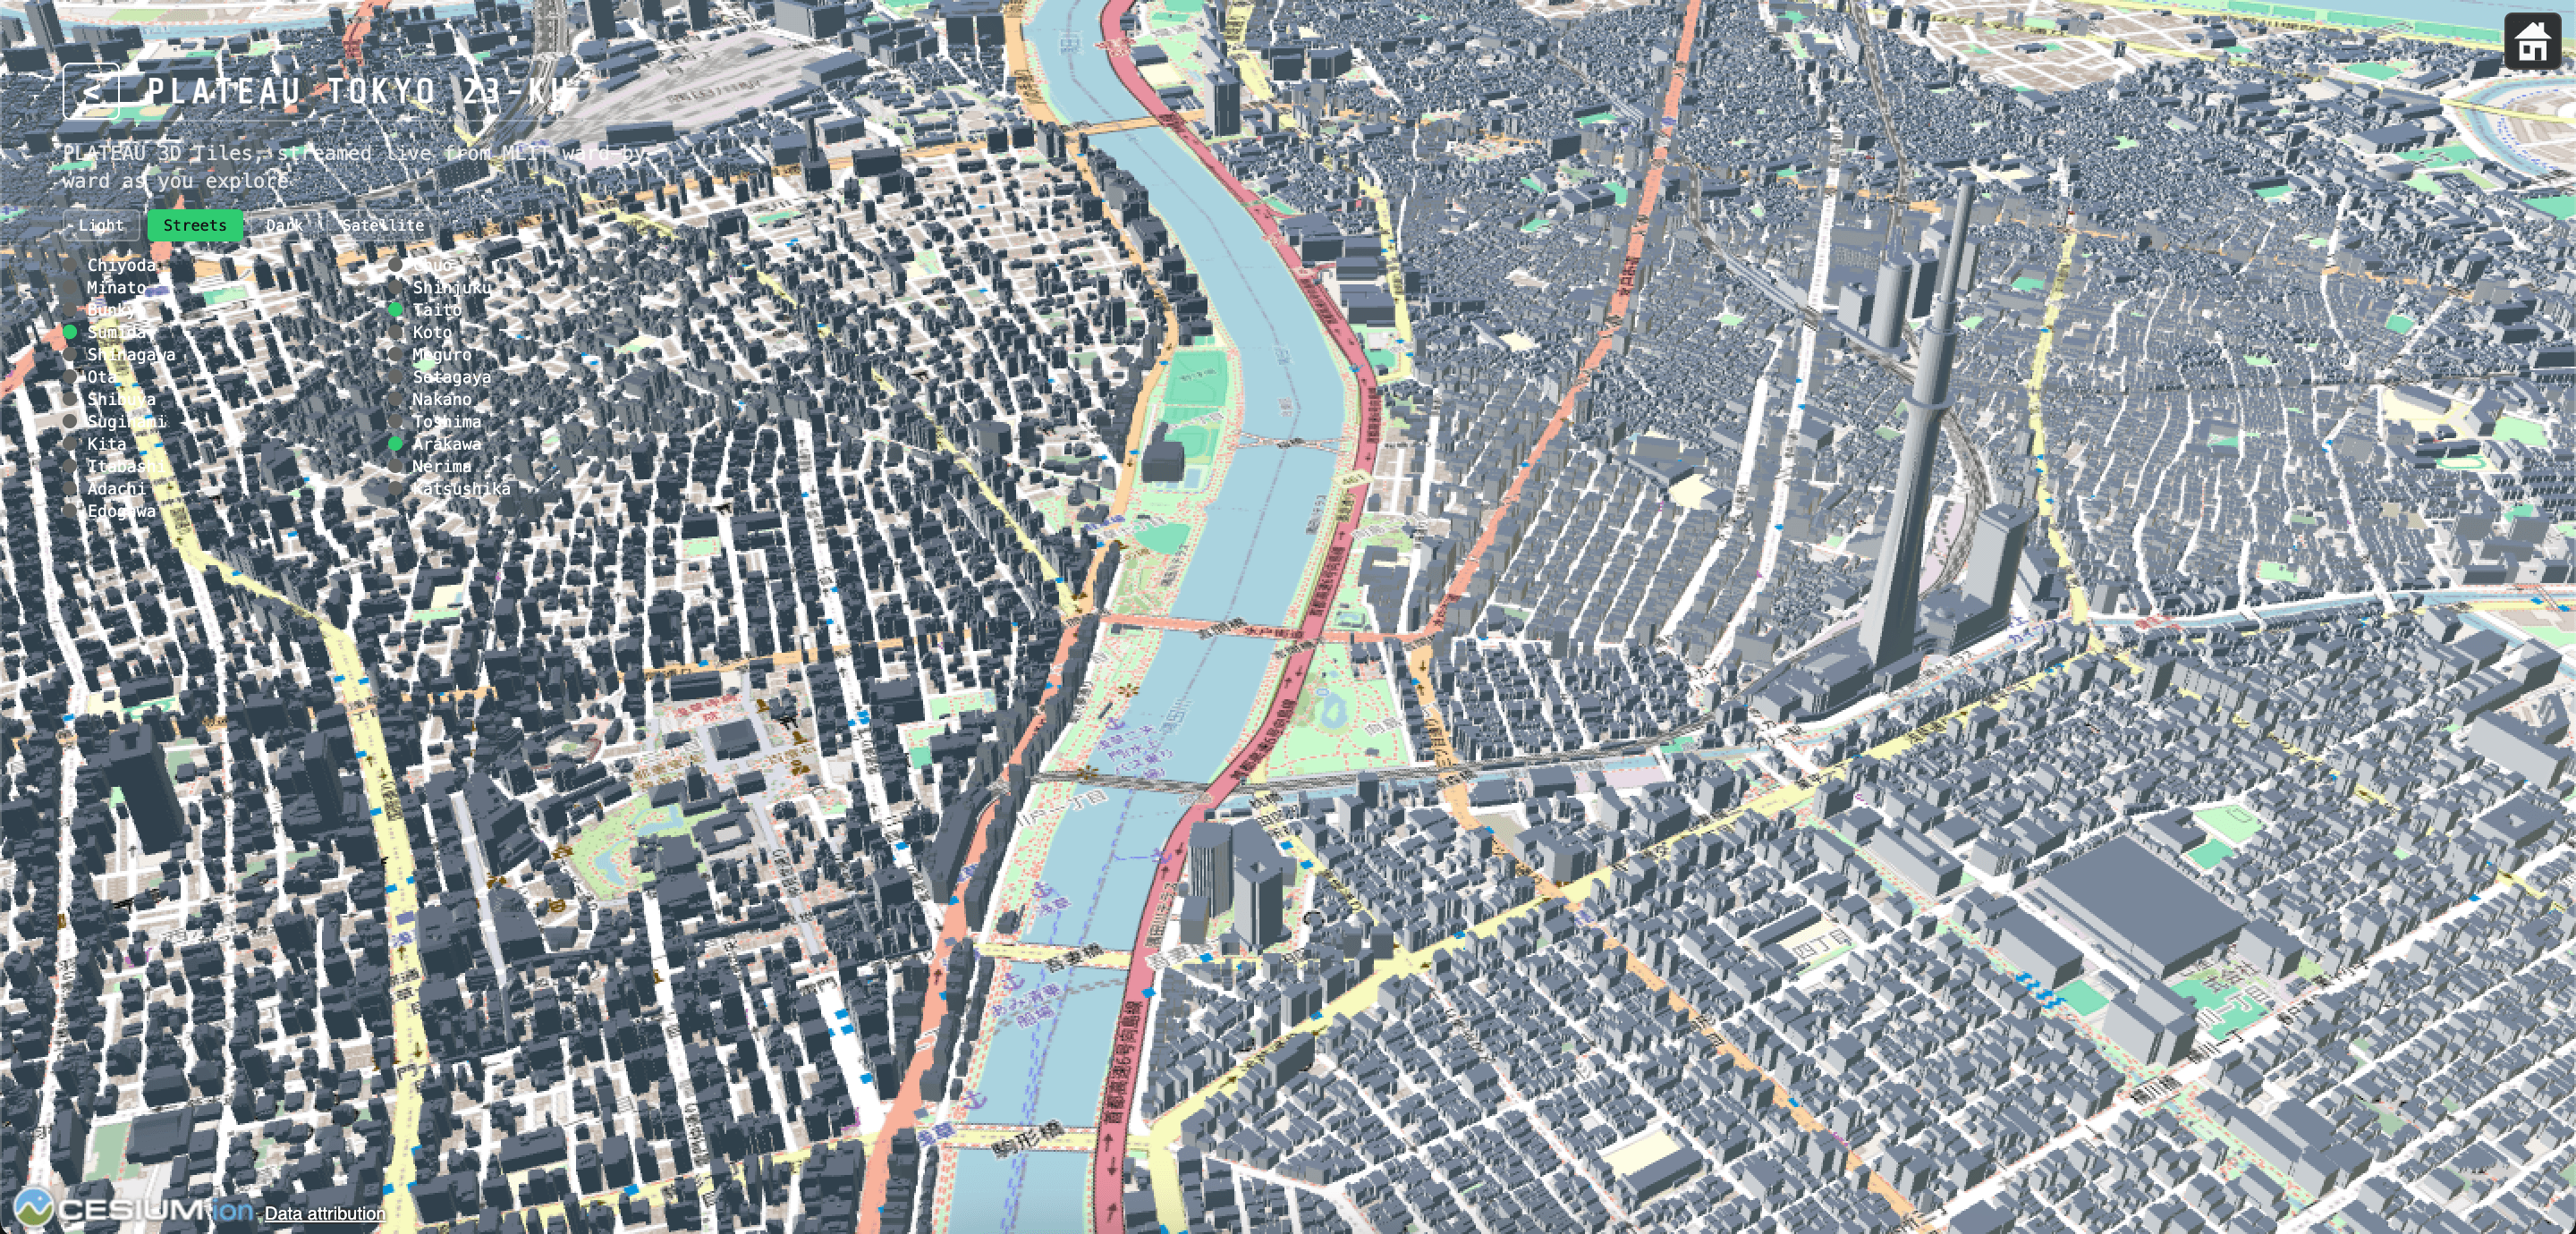
Cesiumを使用して日本の3D地図デモを構築する際、国土交通省 of 3D都市モデルデータであるPLATEAUと、リアルタイム of 列車位置を含む公共交通データであるODPTを組み合わせることは、一見すると非常にシンプルに思えるかもしれません。
一方が3D都市を提供し、もう一方が走る列車を提供する。単にこれら2つのデータソースを同じ地図上に配置するだけで済むのでは?
実際はそれほど単純ではありません。
PLATEAUとODPTはどちらも非常に有用なオープンデータソースですが、それぞれ座標系、スキーマ、データの安定性、パフォーマンス、スケジュール、そしてデータセット間の連携方法において、独自の限界を抱えています。
cesium-plateauデモの開発プロセスにおいて、私たちは多くの興味深い課題に直面しました。コードで解決できる問題もあれば、一定の誤差を許容してベストエフォート(best-effort)なアプローチでシステムを設計せざるを得ない問題もありました。
本記事では、最も重要な課題とその解決策についてまとめます。
1. PLATEAU 3D Tiles: 3D都市は単にtilesetをロードするだけではない
PLATEAUは、建物(building)や橋梁(bridge)を3D Tiles形式で提供しており、独自のバックエンドやCesium ionトークンを必要とせず、tileset.jsonを介して直接ストリーミングできます。
これは非常に便利ですが、データをCesiumにインポートすると、いくつかの問題が発生し始めます。
2. なぜ建物が地面の上に「浮いて」いるのか?
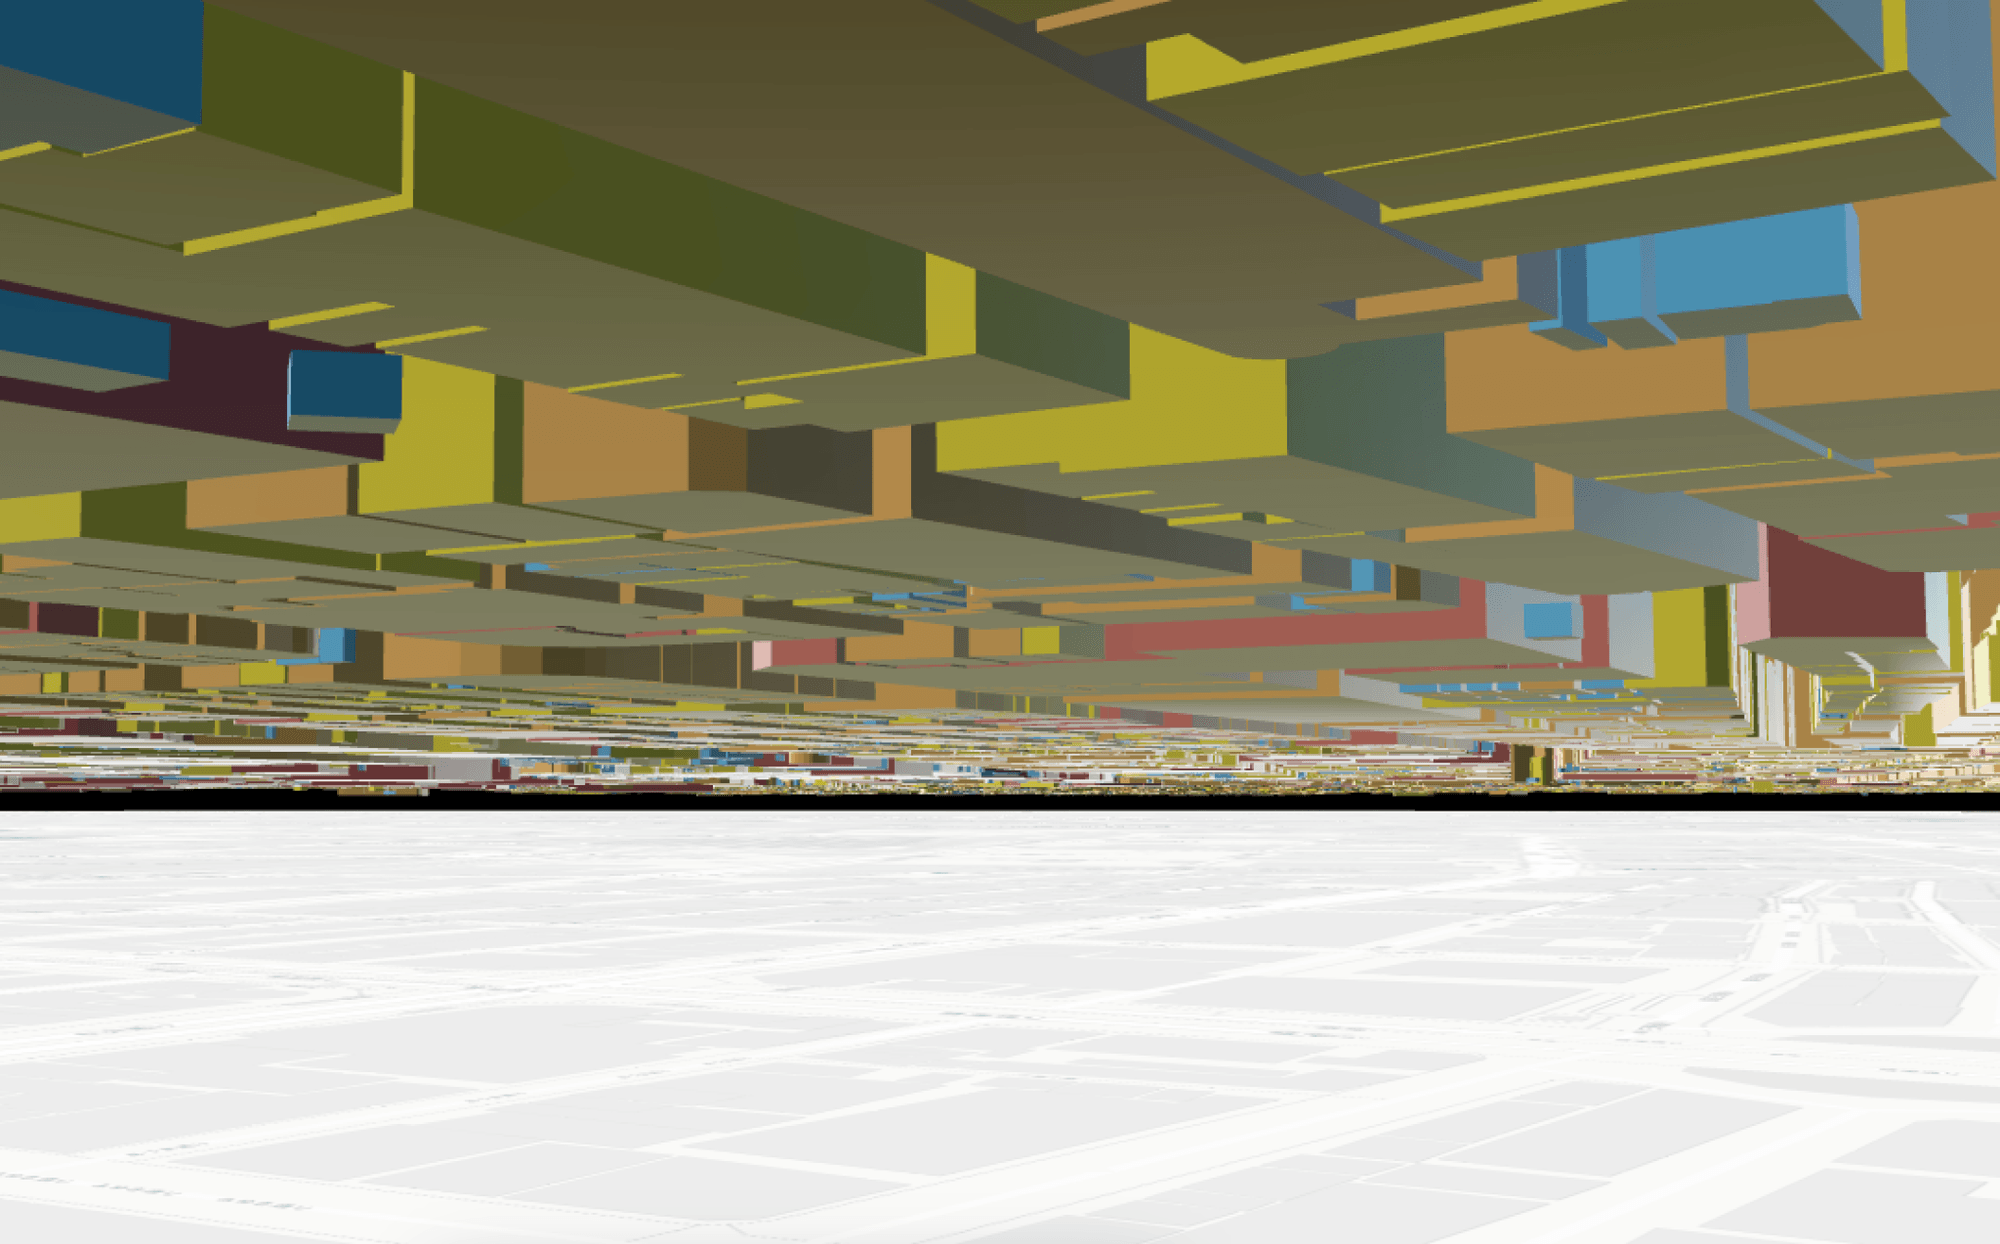
最初に気づく分かりやすい問題の1つは、一部の建物が地面から数十メートル浮いていることです。
その原因は、高さの基準となる座標系の違いにあります。
PLATEAUはJGD2011ジオイドに基づく高さを基準にしていますが、CesiumはWGS84楕円体に基づいてtilesetを配置します。
真上から見下ろす(俯瞰する)とこの隙間は分かりにくいですが、カメラを傾けると、建物と道路の間の隙間が非常に明確になります。
すべての場所に適用できる正確なオフセット値は存在しない
単純な解決策としては、tileset全体の高さ(height)に一定の値を加算または減算することです。
しかし、ジオイドと楕円体の差(ジオイド高)は地域によって異なります。そのため、東京全体に正確に適用できる単一のオフセット値は存在しません。
当プロジェクトでは、単にグローバルなZ軸を変更するのではなく、バウンディングスフィアの中心における法線方向に沿ってtileset全体を平行移動する方法を採用しました。
オフセット値は、実行時に setHeightOffset を介して調整されます。
これにより、固定の値をハードコーディングすることなく、エリアごとに建物の位置を微調整することが可能になります。
3. PLATEAUのアセットURLを直接保存してはいけない
もう1つの、あまり目立たない問題は、データセットのURLを扱う際に発生します。
国土交通省が特定の区(ward)のデータを再処理するたびに、CDN上のアセットパスやハッシュが変更される可能性があります。
アプリケーションが現在のアセットURLを直接保存している場合、データセットの次回の更新後にそのURLが404エラーになる可能性があります。
解決策:datacatalogエンドポイントを使用する
CDNのURLを直接保存する代わりに、プロジェクトでは国土交通省が提供する安定したエンドポイントを使用しています:
datacatalog/3dtiles/<ward>-bldg-lod2-...
このエンドポイントは、実際の tileset.json を解決(resolve)するためのインデックスレイヤーとして機能します。
その代わり、各区について追加の小さなネットワークリクエストが発生しますが、それと引き換えに重要なメリットが得られます。国土交通省がデータを再処理しても、データセットへのリンクが切れないということです。
4. テクスチャは美しいが、常に最適とは限らない
PLATEAUには、実世界の写真テクスチャを持つLOD2バージョンが存在します。
近くにズームすると非常に美しく見えます。
しかし、ズームアウトすると、パフォーマンスが問題になり始めます。
テクスチャ付きのタイルは、テクスチャなしのバージョンよりも3〜10倍大きくなることがあります。場合によっては、1つのタイルのサイズが数MBに達することもあります。
カメラを遠くに引くと、Cesiumは同時に100以上のタイルをロードしなければならない場合があります。
この場合のボトルネックは、必ずしも同時リクエスト数ではなく、データをロードするために必要な帯域幅です。
なぜプロジェクトは lod2-notexture を選んだのか?
プロジェクトでは、安定した読み込み速度を確保するために、実世界のテクスチャを諦める選択をしました。
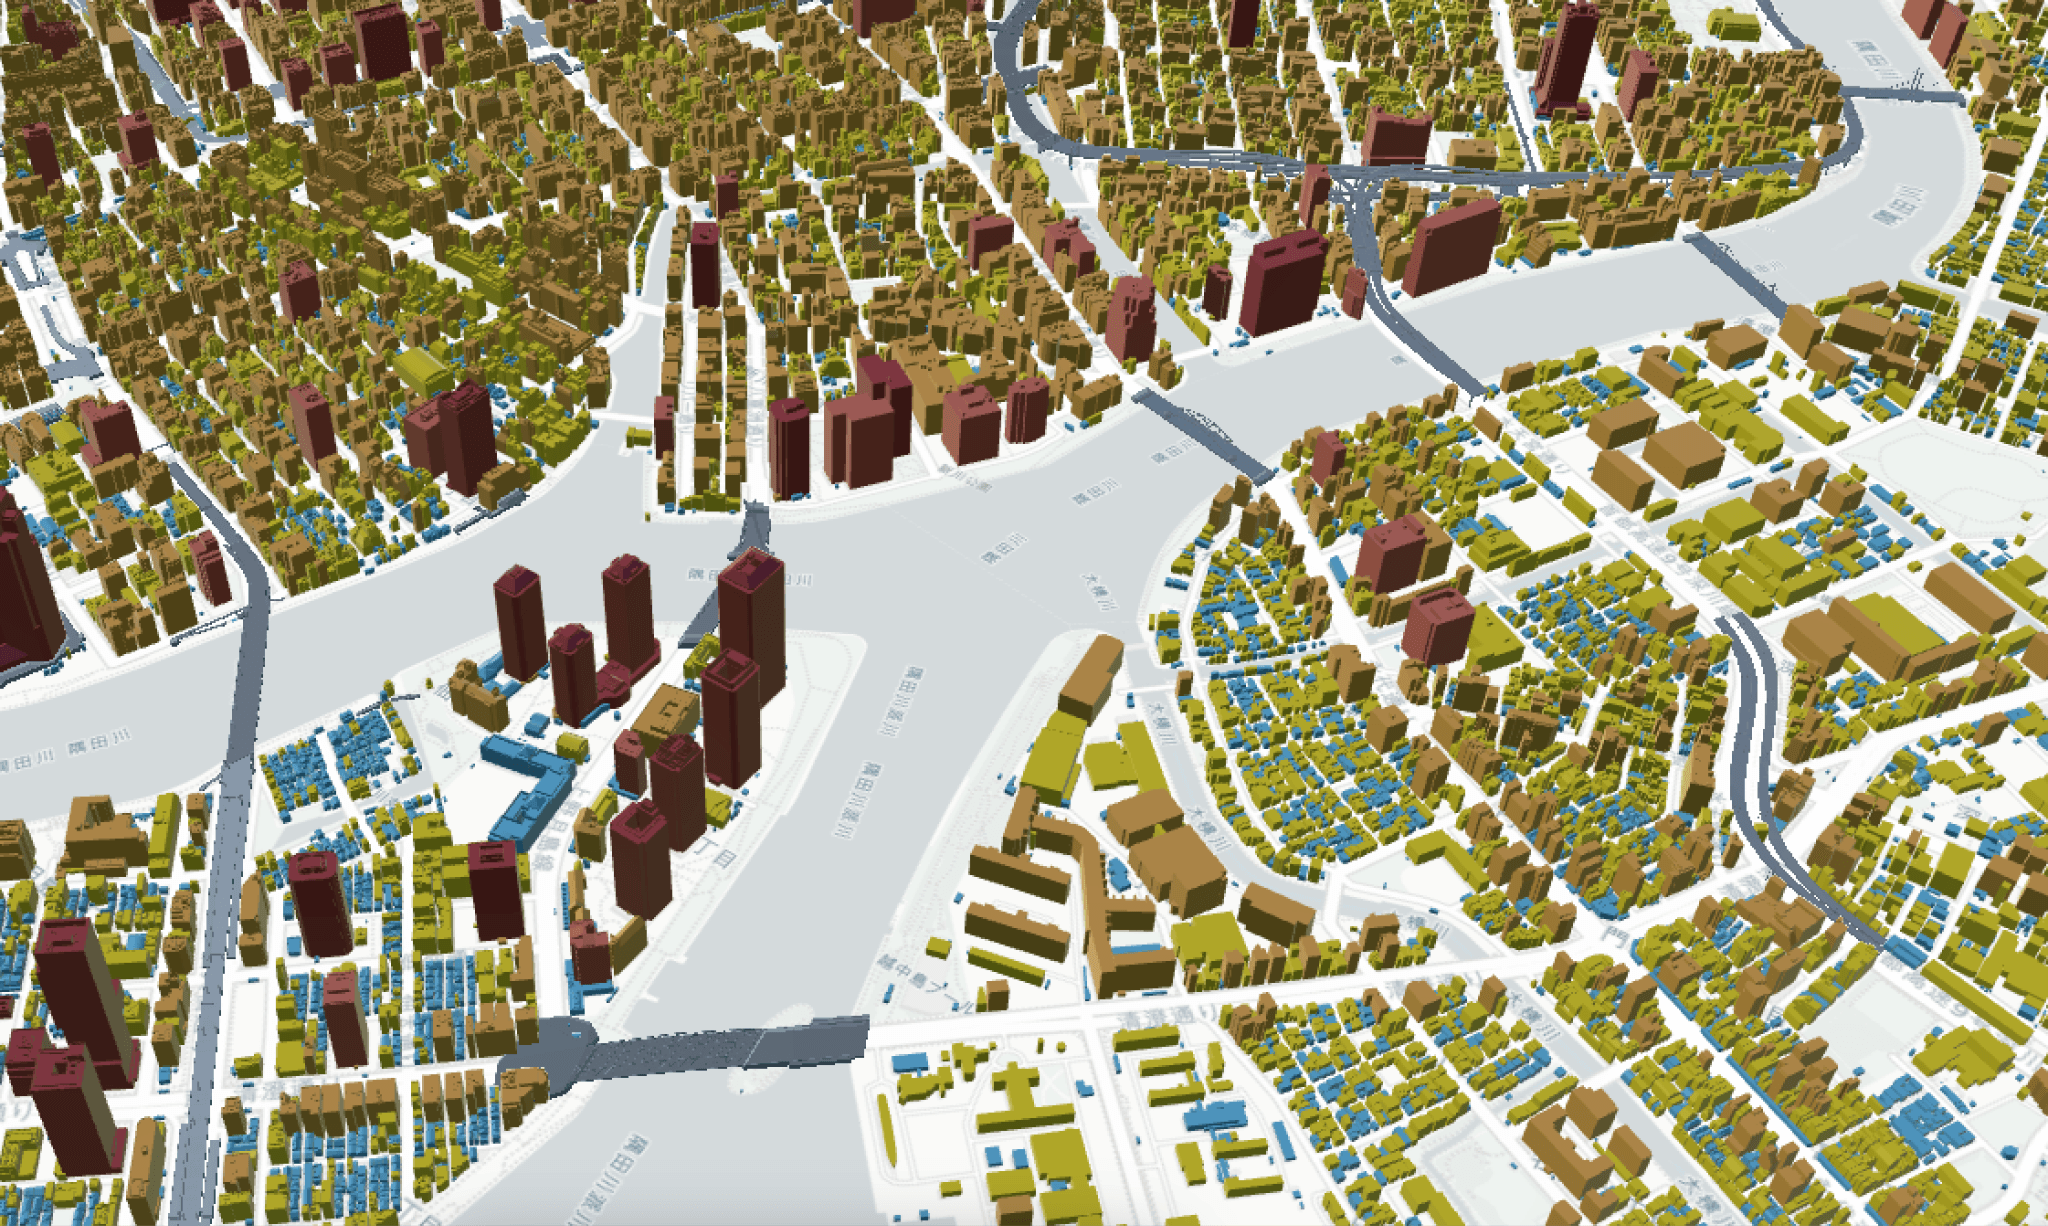
建物は、以下のような属性に基づいて 3D Tiles Style を使用して色分けされます:
- 高さ (Height)
- 用途 (Usage)
- 浸水リスク (Flood risk)
これは、単に都市を美しく表示するだけでなく、データ分析を必要とするビジュアライゼーションに特に適しています。
5. 橋梁(Bridge)は建物(Building)とは異なる
PLATEAUは、橋梁を建物と同じようには整理していません。
建物は bldg スキーマを使用しますが、橋梁は brid を使用します。
また、橋梁には軽量なテクスチャなし(notexture)バージョンがありません。
さらに注目すべきは、23区すべてに橋梁のデータがあるわけではないという点です。約3分の1の区には橋梁のデータセットが存在しません。
したがって、橋梁のtilesetが空であっても、それをエラーとして扱うべきではありません。
プロジェクトでは、橋梁を独立したレイヤーとして処理しています:
- Buildings
- └── Building Tileset
- Bridges
- └── Bridge Tileset
setBridgesVisible も建物とは個別に分離されています。
橋梁データがない区については、リクエストをリトライしたり警告を表示したりするのではなく、正常な状態として扱います。
6. 未定義(undefined)のフィールドがレンダーループ全体をクラッシュさせることがある
最も厄介なエラーの1つは、3D Tiles Styleから発生します。
例えば、フィールド:
- bldg:measuredHeight
は、フィールド名に「:」が含まれているため、${...} という短縮表記で直接使用することはできません。
代わりに、以下のように記述する必要があります:
- ${feature['bldg:measuredHeight']}
しかし、それは最大の困難ではありません。
一部のフィーチャには、このフィールド自体が存在しない(undefined)場合があります。もしスタイル式で以下のような比較を行うと:
- height >= 100
未定義の値と比較された場合、Cesiumは RuntimeError をスローすることがあります。
恐ろしいのは、これが単一のフィーチャのエラーにとどまらないことです。
レンダーループ全体をクラッシュさせる可能性があります。
解決策
比較する前に型キャストを行います:
- Number(${feature['bldg:measuredHeight']})
Number(undefined) は NaN を返します。
この場合、比較は false を返し、フィーチャはシステム全体を破損させることなくデフォルトの色の分岐にフォールバックします。
これは、Cesiumスタイルを記述する際の非常に重要な原則です:
「すべてのフィーチャが完全なプロパティを持っていると仮定してはならない。」
7. PLATEAUは常に列挙型(enum)を返すわけではない
別の例として、以下のようなものがあります:
- bldg:usage
これは、固定の列挙型コードではなく、以下のような日本語のラベルを直接返すことがあります:
- 業務施設
- 商業施設
また、出現する可能性のあるすべての値を網羅した完全なリストは存在しません。
そのため、プロジェクトでは現在のマッピングが完全であるとは仮定しません。
代わりに、以下のように処理します:
その代わりに:
既知の値 (Known value)
↓
一致するカテゴリ (Matched category)
↓
カテゴリの色 (Category color)
未知の値 (Unknown value)
↓
ニュートラルなフォールバック色 (Neutral fallback color)
未知の値はエラーとして扱うのではなく、「未分類」として処理します。
8. 浸水リスク(Flood risk):1つの河川、1つのフィールド?
これは、スキーマの問題に関する最も興味深い例の1つです。
PLATEAUには、各河川システムに関連する危険(hazard)フィールドがあります。フィールド名は地域によって変わることがあります。
わずか2つの区を調査しただけで、7つの異なるフィールド名が観察されました。
アプリケーションが特定の河川の特定のフィールドを選択した場合、その河川が流れていない別の区では、単にデータがないために誤って「安全」と表示されてしまう可能性があります。
トレードオフ
プロジェクトでは、各区で一貫した名前を持つ高潮(storm surge)に関するフィールドを使用することに決定しました。
これは河川によるすべての浸水シナリオを代表するものではありませんが、引き換えにアプリケーション全体で一貫したプロパティを確保できます。
これは重要なトレードオフです:
「範囲は狭くても一貫したデータセットの方が、範囲は広くてもスキーマが不安定なデータセットよりも有用な場合がある。」
9. 距離に応じた区(ward)のロードとアンロード
東京には23の区があります。すべての建物のtilesetを同時にロードすると、アプリケーションは膨大なデータ量を処理しなければならなくなります。
プロジェクトでは、3つのパラメータを使用しています:
- LOAD_DISTANCE_METERS
- UNLOAD_DISTANCE_METERS
- MAX_ACTIVE_WARDS
当初、距離はカメラの完全な3D位置に基づいて計算されていました。
しかし、これには問題がありました。
ホームビュー(初期表示)では、カメラの高度が約1200mに達することがあり、これにより区までの距離が即座にしきい値を超えてしまいます。結果として、どの区もロードされなくなってしまいました。
解決策
距離はカメラの高度を無視し、カメラを地面に投影した位置に基づいて計算されるようにしました。
また、ヒステリシス(履歴現象)も導入しました:
ロード (Load): 2500m
アンロード (Unload): 4500m
単一のしきい値のみを使用した場合、カメラが境界付近を行き来すると、tilesetが頻繁に:
ロード → アンロード → ロード → アンロード
を繰り返してしまいます。
2つの異なるしきい値を設けることで、この現象を防ぎます。
- MAX_ACTIVE_WARDS = 5
とすることで、アクティブな区の数を常に制限します。
制限を超えた場合は、最も遠い区がアンロードされます。
10. Cesiumの60 FPSは常に必要とは限らない
Cesiumのシーンがほとんど静止していても、デフォルトでは毎秒60フレームでレンダリングが続けられます。
これは、カメラが動いていなくてもGPUが作動し続けることを意味します。
プロジェクトでは:
- requestRenderMode: true
を設定し、シーンに実際に変更があった場合のみ再レンダリングを行うようにしました。
さらに:
- maximumScreenSpaceError: 24
- skipLevelOfDetail
- cullRequestsWhileMoving
これらを使用して、不要なデータとリクエストを削減しています。
別の実験として dynamicScreenSpaceError も試しました。
しかし、近距離でほぼ垂直に見下ろすビューでは、カメラが静止していてもLODがちらつく現象が発生しました。
そのため、プロジェクトではダイナミックではなく固定の maximumScreenSpaceError を選択しました。
11. ODPT: リアルタイムデータがあるからといって、すべてがリアルタイムというわけではない
PLATEAUの処理を終えた後、次の難関はODPTでした。
ODPTは以下のデータを提供します:
- 列車位置 (Train position)
- 駅 (Stations)
- 路線・線路 (Railway)
- 時刻表 (Timetable)
プロジェクトでは、開発者のコンシューマーキーを保護するために、ODPTとOverpassはバックエンド経由でプロキシされています。
12. GTFS-Realtimeは列車がどの路線を走っているかを直接教えてくれない
これはリアルタイムデータの最大の制限の1つです。
JR東日本のGTFS-Realtimeフィードにおいて、TripDescriptor には tripId はありますが、routeId がありません。
プロジェクトで tripId とカタログの odpt:Train を結合しようと試みましたが、結果は:
「415件中0件の tripId が trainNumber と一致」
でした。
つまり、2つのシステムにおけるIDを直接結合することはできません。
したがって、以下を確実にする方法はありません:
「この列車は路線Xを走っている。」
解決策:位置からの推論
プロジェクトでは、列車の位置情報を使用し、330m以内で最も近い路線のポリライン(railway polyline)を検索します。
この結果を:
ベストエフォートな路線推論 (best-effort route inference)
として扱います。
これが絶対的に正確なデータであるかのように偽ることはしません。
オープンデータからビジュアライゼーションシステムを構築する際、これは重要なポイントです:
「ソースデータが直接情報を提供していない場合は、どこが本当のデータで、どこが推論されたデータなのかを明確にすること。」
13. 5つの事業者があるが、リアルタイムの列車データがあるのはJR東日本のみ
ODPTは、複数の事業者のデータを提供しています:
- JR東日本
- 東京メトロ
- 都営地下鉄
- ゆりかもめ
- りんかい線
しかし、Challenge 2026において、現在も稼働しているGTFS-RealtimeフィードはJR東日本のものだけです。
他の4つの事業者のフィードは404エラーを返します。
これにより、以下のような非常に明確な設計となりました:
駅・路線 (Stations / Railway)
├── JR東日本
├── 東京メトロ
├── 都営地下鉄
├── ゆりかもめ
└── りんかい線
リアルタイム列車アニメーション (Realtime Train Animation)
└── JR東日本
存在しないエンドポイントへのリトライを行わないことで、不要なリクエストを削減し、アプリケーションがエラーを起こしているかのような印象を与えるのを避けます。
14. 20秒ごとのポーリングだが、列車位置の更新は40〜90秒ごと
これは、APIのポーリング頻度(polling frequency)とデータの更新頻度(data update frequency)の違いを示す典型的な例です。
クライアントは20秒ごとにフィードをポーリングします。
しかし、同じ車両IDを追跡すると、レスポンスの大部分は前回と同じ座標を返します。
実際の列車の位置は、約40〜90秒ごとにしか変わりません。
新しいデータを受信し、マーカーを新しい位置に直接スナップ(瞬間移動)させると、アニメーションは以下のようになります:
列車がしばらく停止した後に、突然ワープするように見えてしまいます。
●──────────────●
^ ^
古い位置 新しい位置
列車がしばらく停止した後に、突然ワープするように見えてしまいます。
クライアントサイドでの補間(Interpolation)
プロジェクトでは、古い位置と新しい位置の間を内挿(補間)しています。
サーバーのフィードは約20秒周期で更新されますが、クライアントのアニメーションティックは300msごとに実行されます。
これにより:
サーバー (Server)
古い位置 ───────── 新しい位置
クライアント (Client)
スムーズな補間
●──●──●──●──●──●──●──●
元のデータ更新がまばらであっても、列車はより滑らかに移動します。
15. ODPTには駅順があるが、線路の形状データはない
ODPTは、駅順(stationOrder)と各駅の座標を提供します。
最も簡単な方法は、以下のように接続することです:
駅A ───────── 駅B
しかし、実際の線路は直線ではありません。
単に2つのポイントを結ぶだけでは、線路が:
- 建物を突き抜ける
- 道路を突き抜ける
- カーブのセクションで誤った方向を向く
ODPTとOpenStreetMapの組み合わせ
プロジェクトでは、Overpassを使用して、以下のタグを持つOSMウェイを取得します:
- railway=rail
その後、路線グラフ(railway graph)を構築します。
隣り合う駅のペアごとに、グラフ上で最短経路を探索し、実際の形状に近い路線ポリラインを抽出します。
このように:
ODPT
駅A ───── 駅B
│ │
↓ ↓
OSM路線グラフ
↓
リアルな線路パス
これは、あるデータソースがセマンティック情報(意味情報)を提供し、別のデータソースがジオメトリ(形状)を提供するという、非常に典型的な連携例です。
2つのソースを組み合わせることで、単一のソースを個別に使用するよりもはるかに優れた結果が得られます。
16. しかし、最短経路が間違った線路を選択することがある
東京には、多くの並走する線路が存在します。
例えば:
- 山手線
- 中央・総武緩行線
- 京浜東北線
1つの駅が、複数の異なる路線のノードの近くに位置することがあります。
もし単に:
- 駅Aを最も近いノードにスナップする
- 駅Bを最も近いノードにスナップする
- 最短経路を探索する
とすると、アルゴリズムは2つの異なる並走する路線のノードを選択してしまう可能性があります。
結果として、経路が非常に遠回り(迂回)になってしまうことがあります。
東京駅 → 神田駅のケースでは、実際の距離が約1.2kmであるのに対し、約7kmの経路が生成されてしまいました。
合計で204ペア中27ペアの駅間でこの種のエラーが発生しました。
マルチソース・マルチターゲットDijkstra法
単一のノードから開始する代わりに、アルゴリズムは開始駅の周辺スナップ半径内にあるすべてのノードから探索を開始します。
同様に、探索は終了駅のスナップ半径内にあるノードに到達した時点で停止します。
結果として、アルゴリズムは最も近い単一のノードに固定されることなく、最も直接的な接続路線を選択できるようになります。
この変更を適用した後:
最悪の迂回率が24倍から1.6倍に減少しました(エラーが発生していた27ペアにおいて)。
これは、グラフ探索の開始点と終了点の選択方法を変更するだけで得られた非常に大きな改善です。
17. 列車が2つの並走路線の間を「ジャンプ」することがある
路線ポリラインが正確に構築された後でも、最も近い距離に基づいて列車を路線にマッチングさせるプロセスには課題が残ります。
実際の列車が以下のように連続してマッチングされることがあります:
中央・総武緩行線
↓
総武快速線
↓
中央・総武緩行線
2つの線路が近すぎるため、最近傍距離マッチング(nearest-distance matching)が不安定になります。
これは特にスタイルとアニメーションで顕著に現れます。
路線IDが変更されると、アーク長に沿った位置(arc-length position)も変化し、列車が逆走しているように見えることがあります。
路線IDの固定(Pin railway ID)
プロジェクトでは、安定性を優先することに決定しました。
車両が特定の路線に一度マッチングされた後:
車両 (Vehicle)
↓
マッチした路線
↓
路線IDを固定 (PIN)
以降のポーリングでは、引き続きその固定された路線IDを使用します。
現在の路線が有効でなくなった場合にのみ、新しい路線を探索します。
これにより、毎回のポーリングで最近傍の路線を検索するよりも、アニメーションが大幅に安定します。
18. すべての事業者が路線構築に必要な十分なデータを持っているわけではない
もう1つの問題は、駅の座標データにあります。
Challenge 2026において、駅のレコードに以下の座標データが含まれているのはJR東日本のみです:
- geo:long
- geo:lat
他の4つの事業者には、このデータソースに座標情報が含まれていません。
座標がなければ、駅をアンカーとしてOSMの路線グラフと結合することができません。
したがって、プロジェクトでは以下のみ路線ポリラインを構築しています:
ODPT_TRAIN_OPERATOR_IDS = JR東日本
これは、データが欠落している他の事業者に対して不確実なポリラインを作成しようとするよりも、現実的な選択です。
19. コンシューマーキーをブラウザに露出させてはいけない
ODPTのコンシューマーキーは登録されたアカウントに関連付けられており、フロントエンドに直接埋め込むべきではありません。
クライアントがAPIを直接呼び出すと:
ブラウザ → ODPT
キーが露出する危険があります。
プロジェクトではバックエンドプロキシを使用しています:
ブラウザ → /api/odpt/* → サーバー → ODPT
同様に、Overpassからの路線データも以下を経由します:
- /api/osm/railways
キーはサーバー上にのみ存在します。
セキュリティの問題に加えて、サーバーはレート制限の管理やキャッシュにも役立ちます。
「1分あたり約20リクエスト/IP」というレート制限も、クライアントのポーリング間隔の設計に直接影響を与えます。
20. 時刻表に実際の祝日カレンダーがない
ODPT時刻表のもう1つの制限はカレンダーです。
JR東日本の時刻表は、基本的に以下のみを区別します:
- 平日 (Weekday)
- 土曜・休日 (SaturdayHoliday)
実際の詳細な祝日カレンダーは提供されません。
例えば、月曜日が祝日であっても、単に平日として扱われてしまう可能性があります。
プロジェクトではこの制限を受け入れ、平日/週末の近似値を使用しています。
もう1つの興味深い詳細は、時刻表内の時間が以下のように表現される場合があることです:
- 25:10
( 01:10 の代わりに)
- 01:10
実際、これは処理において非常に好都合です。
時間を「深夜0時からの経過分数(minutes from midnight)」として扱い、1439分に制限しない場合、25:10 は自然に 23:59 の後に配置されます。
深夜以降の時間に対して特別なロジックを追加する必要がありません。
21. Cesium特有の問題:BoxGraphicsには scaleByDistance がない
列車を本物の車両らしく見せるため、プロジェクトではマーカーをポイントから BoxGraphics に変更しました。
しかし、BoxGraphics には以下が標準で備わっていません:
- disableDepthTestDistance
- scaleByDistance
これらの2つのプロパティは、PointGraphics や BillboardGraphics では非常に便利です。
解決策
プロジェクトでは、カメラとの距離に基づいてボックスのサイズを手動で計算しています:
カメラ → 列車までの距離 → 寸法の計算 → BoxGraphicsのリサイズ
画面上の表示サイズがズームレベルに関わらずほぼ一定になるよう、各ティックごとに3Dの寸法を調整しています。
その代わり、プロジェクトでは現実のオクルージョン(遮蔽)を維持しています:
建物が列車の前にある場合、列車は建物によって隠されます。
これは3Dシーンをより自然にするため、許容できる設計上の選択と見なされています。
22. テストプロセス中に発見された課題
対処された課題に加えて、テストプロセス中に完全には解決されていない2つの問題が発見されました。
列車のステータスが常に「Unknown」と表示される
GTFS-Realtimeは、currentStatus を数値の列挙型として返します:
0, 1, 2
一方で、UIのルックアップテーブルは以下のような文字列のキーを使用しています:
- INCOMING_AT
- STOPPED_AT
- IN_TRANSIT_TO
そのため、数値でのルックアップは決して一致しません。
推奨される解決策は、まず数値の列挙型を名前の文字列にマッピングすることです:
- 0 → INCOMING_AT
- 1 → STOPPED_AT
- 2 → IN_TRANSIT_TO
その後、それをUIのラベルテーブルに入力します。
駅に停車中の列車をクリックすると、常に駅が選択されてしまう
これはCesiumにおけるピッキング(picking)の問題です。
駅のマーカーは以下を使用しています:
- disableDepthTestDistance: Infinity
そのため、深度テストに関わらず常に最前面に配置されます。
一方、列車は BoxGraphics を使用しており、通常通り深度テストの影響を受けます。
列車が駅にちょうど停車しているとき:
列車 (Train)
駅 (Station)
クリックすると、常に列車の代わりに駅が返される可能性があります。
提案されている解決策は、drillPick と同様のロジックを適用することです:
トップの選択 = 駅
↓
周囲の列車をチェック
↓
列車が存在する?
↓
列車を選択(ピック)
これにより、列車が駅と同じピクセル上に重なっている場合、列車を優先して選択できるようになります。
23. より大きな教訓
PLATEAU、ODPT、OSM、そしてCesiumを組み合わせた後、他のビジュアライゼーションプロジェクトにも応用できるいくつかの重要な教訓が得られました。
1. オープンデータが完璧なデータであるとは限らない
オープンデータには以下が欠けている場合があります:
- フィールド (field)
- 列挙型 (enum)
- 座標 (coordinate)
- リアルタイム更新 (realtime update)
- 安定したID (stable ID)
- 形状データ (geometry)
スキーマが常に完全であるという仮定に基づいてアプリケーションを設計すべきではありません。
2. 「実データ」と「推論データ」を区別しなければならない
例えば:
列車の位置 (Train position)
→ 実データ
列車の路線 (Train route)
→ ベストエフォートな推論
these 2種類のデータは、異なる信頼レベルとして処理および表示される必要があります。
3. 形状とセマンティックデータは相互に補完し合える
ODPTは以下を知っています:
駅A → 駅B
OSMは以下を知っています:
実際の線路がどのように走っているか
2つのソースを組み合わせることで、それぞれを個別に使用するよりもはるかに良い結果が得られます。
4. 安定性が絶対的な正確さよりも重要な場合がある
例えば、ポーリングのたびに最も近い線路に列車をマッチングさせることは、理論的には「正確」に見えるかもしれません。
しかし、並走する2つの路線の間で列車が絶えず入れ替わると、アニメーションの品質は最悪になります。
路線IDを固定することで、より安定した結果が得られます。
リアルタイムのビジュアライゼーションにおいて:
「少し不正確であっても、安定している結果の方が、絶えず変動する結果よりも優れていることが多い。」
Một kết quả hơi sai nhưng ổn định thường tốt hơn một kết quả thay đổi liên tục.
5. パフォーマンスは単にFPSだけの問題ではない
大規模な3D地図を作成する場合、パフォーマンスは以下にも関係します:
- ネットワーク帯域幅
- アクティブなタイルの数
- LOD
- GPUレンダリング
- リクエスト頻度
- メモリ使用量
- データ更新頻度
例えば、PLATEAUのテクスチャは主に帯域幅の問題を引き起こしますが、CesiumのレンダーループはGPU/消費電力の問題を引き起こします。
最適化を行う前に、ボトルネックを正しく特定する必要があります。
結論
CesiumにおいてPLATEAUとODPTを統合することは、単に以下を行うだけの単純な作業ではありません:
3Dビルのロード
+
列車位置 of ロード
=
リアルタイム3D都市
実際には、座標系、不安定なアセットURL、LOD、欠落しているデータセット、未定義のプロパティ、一貫性のないスキーマから、リアルタイムフィード、路線のマッチング、グラフのルーティング、位置の補間、アンドAPIセキュリティに至るまで、一連の課題を解決する必要があります。
さらに重要なことに、元のデータの制限により、多くの問題は完全に「修正」することができません。
その場合、最も効果的なアプローチは以下の通りです:
「データの制限を明確に理解する → トレードオフを決定する → 十分に良い方法を選択する → どこが実データでどこが推論データかを明確にする」
それこそが、オープンデータからリアルタイムの3D地図を構築することを、単にCesium上にいくつかのtilesetやマーカーを表示するよりもはるかに面白く、やりがいのある課題にしている理由です。
1,000社以上の事業成長を支えた圧倒的な『スピードと柔軟性』で、御社のアイデアを最短で形にします。まずは無料で壁打ちしませんか?